Unit 42 nói không mô hình AI đơn lẻ nào bao phủ quá 40% lỗ hổng trong môi trường phức tạp. Bài học nằm ở điều phối và xác thực đa mô hình.
Unit 42: một mô hình AI chỉ thấy tối đa 40% lỗ hổng
Tóm tắt: Palo Alto Networks công bố dịch vụ Continuous Frontier AI Defense dùng nhiều mô hình AI để kiểm thử bảo mật liên tục. Theo đánh giá nội bộ của Unit 42, không mô hình đơn lẻ nào tìm được hơn 40% lỗ hổng trong môi trường phức tạp; độ trùng giữa hai mô hình cyber hàng đầu còn dưới 10%. Con số đáng chú ý, nhưng cần đọc như dữ liệu của nhà cung cấp về chính dịch vụ họ bán, không phải benchmark độc lập cho mọi hệ thống.
Ngày 22/09/2026, Palo Alto Networks ra mắt Unit 42 Continuous Frontier AI Defense. Dịch vụ dùng Claude Mythos 5, GPT-5.6-Cyber và các mô hình open-weight trong một lớp điều phối đa mô hình để tìm, xác thực và hỗ trợ khắc phục điểm yếu trên ứng dụng web, API, cloud, mã nguồn và tài sản mạng.
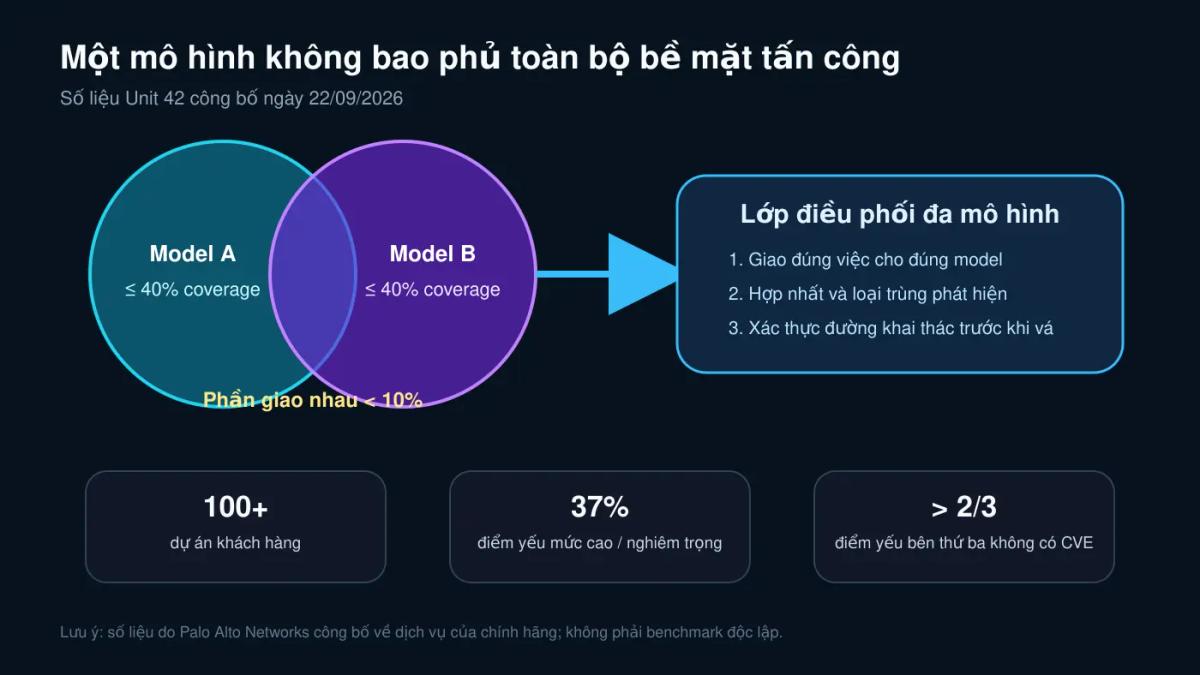
Điểm đáng quan tâm không nằm ở tên sản phẩm, mà ở kết quả đánh giá của Unit 42: không một mô hình đơn lẻ nào bao phủ quá 40% lỗ hổng trong môi trường phức tạp. Với Claude Mythos 5 và GPT-5.6-Cyber, phần điểm yếu mà cả hai cùng nhận diện chiếm dưới 10%.
“Tối đa 40%” thực sự nói lên điều gì?
Con số này không có nghĩa mô hình AI chỉ chính xác 40%. Nó nói về độ bao phủ: trong tập điểm yếu Unit 42 đánh giá trên mã nguồn doanh nghiệp và môi trường vận hành thật, mỗi mô hình phát hiện một phần khác nhau và không mô hình nào bao phủ quá hai phần năm.
Độ trùng dưới 10% giữa hai mô hình còn gợi ý rằng chúng nhìn thấy các nhóm điểm yếu khác nhau. Nếu chỉ thay mô hình A bằng mô hình B, doanh nghiệp có thể đổi loại blind spot chứ chưa chắc giảm tổng blind spot. Kiến trúc đa mô hình vì thế phải có lớp phân việc, hợp nhất bằng chứng và xác thực khai thác — không đơn giản là hỏi nhiều chatbot rồi cộng câu trả lời.
Unit 42 công bố thêm những số nào?
Palo Alto Networks cho biết cách tiếp cận được phát triển và kiểm tra trong sáu tháng, với hơn 100 dự án khách hàng và khoản đầu tư 17 triệu USD cho R&D cùng tối ưu phương pháp. Trong triển khai nội bộ, hãng nói hệ thống tìm lượng điểm yếu tương đương hơn một năm kiểm thử xâm nhập truyền thống chỉ trong ba tuần.
- 3,2 lần nhiều lỗ hổng mức cao và nghiêm trọng trên mỗi sản phẩm so với phương pháp kiểm thử cũ trong triển khai nội bộ.
- Giảm 51% thời gian trung bình khắc phục theo công bố của hãng.
- 37% điểm yếu được tìm thấy trong đánh giá khách hàng được xếp mức cao hoặc nghiêm trọng.
- Hơn hai phần ba điểm yếu đã xác thực trong ứng dụng bên thứ ba không có CVE đã biết.
Các con số đều do Palo Alto Networks công bố. Trang giới thiệu không cung cấp đầy đủ mẫu kiểm thử, cách chọn khách hàng, baseline chi tiết và tiêu chí thống kê để bên ngoài tái lập. Vì vậy, chúng hữu ích như một signal vận hành nhưng chưa đủ để kết luận mọi doanh nghiệp sẽ đạt cùng mức cải thiện.
Tại sao nhiều mô hình chưa đủ?
Phát hiện không đồng nghĩa khai thác được
Mô hình có thể nêu một khả năng, nhưng đội an ninh cần chứng minh đường tấn công có thật, xác định tài sản bị ảnh hưởng và loại false positive. Unit 42 đưa con người và threat intelligence vào vòng xác thực trước khi ưu tiên khắc phục.
Lỗ hổng riêng lẻ có thể nhỏ nhưng chuỗi lại nguy hiểm
Palo Alto Networks nêu một tình huống ngành tài chính gồm liên kết thanh toán không xác minh lại danh tính, bước OTP bị bỏ qua và lỗi định tuyến phiên. Mỗi vấn đề riêng có vẻ hạn chế, nhưng khi xâu chuỗi có thể dẫn đến chiếm tài khoản và gian lận thanh toán mà nạn nhân không cần hành động.
Kiểm thử liên tục tạo ra rủi ro vận hành mới
Một agent offensive chạy thường trực có thể gửi lưu lượng, chạm dữ liệu nhạy cảm hoặc làm thay đổi hệ thống nếu phạm vi không được khóa. Doanh nghiệp cần sandbox, giới hạn tốc độ, phân tách production và điều kiện phê duyệt trước các thử nghiệm có tác động.
Năm câu hỏi trước khi dùng AI để kiểm thử bảo mật
- Phạm vi: agent được phép thử tài sản, tenant và môi trường nào?
- Dữ liệu: mã nguồn, telemetry và bằng chứng khai thác được giữ ở đâu, trong bao lâu?
- Danh tính: mỗi mô hình và worker dùng credential riêng hay dùng chung quyền?
- Xác thực: phát hiện nào phải được con người hoặc hệ thống độc lập kiểm tra lại?
- Khắc phục: ai chịu trách nhiệm nhận ticket, vá, kiểm thử lại và đóng bằng chứng?
Fact và nhận định cần tách biệt
Fact đã xác minh: Palo Alto Networks công bố dịch vụ toàn cầu theo gói thuê bao năm; lớp điều phối dùng Claude Mythos 5, GPT-5.6-Cyber và mô hình open-weight. Unit 42 nói không mô hình đơn lẻ nào bao phủ hơn 40% lỗ hổng trong môi trường phức tạp và hai mô hình cyber hàng đầu có mức trùng dưới 10%.
Nhận định của Học viện AI: bài học thực tế không phải “càng nhiều model càng tốt”. Giá trị chỉ xuất hiện khi doanh nghiệp biết giao đúng việc cho từng model, hợp nhất bằng chứng, kiểm soát chi phí và buộc mọi phát hiện quan trọng đi qua bước xác thực trước khi thay đổi production.
Có thể đối chiếu với bài Zero Data Retention cho dữ liệu doanh nghiệp, vụ SalesBleed cho thấy AI Agent có thể làm rò dữ liệu CRM và cách quản trị quyền AI Agent qua MCP. Ba lớp dữ liệu, quyền và xác thực phải đi cùng nhau.
Nếu doanh nghiệp muốn thử AI Agent trên môi trường thật mà vẫn giữ phạm vi và trách nhiệm rõ ràng, hãy nhận proposal thiết kế kiểm thử và kiểm soát theo quy trình thực tế.
Nguồn tham khảo
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI