Palantir và Nvidia siết AI vì dữ liệu: zero-retention thành điều khoản mua hàng
Tranh luận về zero-data-retention cho thấy doanh nghiệp không thể chỉ hỏi nhà cung cấp AI có dùng dữ liệu để huấn luyện hay không; hợp đồng còn phải làm rõ thời gian lưu, ngoại lệ an toàn, metadata và phạm vi từng tính năng.
Fact: Ngày 14/9/2026, Reuters dẫn lại The Information cho biết Palantir, Nvidia và Booz Allen Hamilton đang hạn chế hoặc cân nhắc hạn chế việc dùng một số mô hình AI do lo ngại về dữ liệu sở hữu độc quyền. Reuters nói chưa nhận được phản hồi ngay từ các bên được nêu tên. Vì vậy, các chi tiết về chính sách nội bộ của ba công ty trong bài này được trình bày là thông tin “theo báo cáo”, không phải xác nhận độc lập từ doanh nghiệp.
Điểm đáng chú ý nhất không nằm ở tên nhà cung cấp nào đang bị hạn chế. Nó nằm ở tiêu chuẩn mua hàng đang dịch chuyển: một cam kết chung kiểu “không huấn luyện trên dữ liệu khách hàng theo mặc định” không còn đủ cho các workload nhạy cảm. Doanh nghiệp bắt đầu hỏi sâu hơn: dữ liệu được giữ bao lâu, có ngoại lệ nào cho an toàn hay pháp lý, metadata nào vẫn tồn tại, và cam kết đó có áp dụng cho toàn bộ tính năng hay chỉ một số API.
Palantir muốn một cam kết không thể rút lại
Theo Reuters, Palantir đã thúc giục Anthropic đưa ra bảo đảm zero-data-retention không thể rút lại trước khi cho phép mô hình xuất hiện trong phần mềm của Palantir. Cùng nguồn tin cho biết Nvidia giới hạn Anthropic ở các tác vụ ít nhạy cảm hơn và dùng mô hình Nemotron cho công việc nội bộ; Booz Allen được cho là cấm dùng mô hình thương mại của Anthropic cho công việc an ninh mạng độc quyền.
Reuters cũng ghi nhận hai phòng thí nghiệm AI nói rằng họ không huấn luyện trên dữ liệu khách hàng theo mặc định trừ khi doanh nghiệp chủ động đồng ý. Nhưng câu hỏi lưu trữ vẫn tách biệt với câu hỏi huấn luyện. Một hệ thống có thể không dùng prompt để huấn luyện mô hình, song vẫn giữ đầu vào hoặc đầu ra trong một thời gian để vận hành dịch vụ, điều tra lạm dụng, đáp ứng luật hoặc phục vụ một tính năng khác.
Tài liệu Privacy Center của Anthropic, cập nhật ngày 1/7/2026, cho biết đầu vào và đầu ra của người dùng API thường được tự động xóa khỏi hệ thống backend trong vòng 30 ngày, với các ngoại lệ như dịch vụ có thời gian lưu dài hơn, thỏa thuận zero-data-retention, thực thi chính sách sử dụng hoặc yêu cầu pháp lý. Một tài liệu khác của Anthropic, cập nhật ngày 9/6/2026, nói zero-data-retention chỉ áp dụng cho các API đủ điều kiện và một số sản phẩm cụ thể, được xét theo từng tổ chức. Nói cách khác, “có ZDR” không đồng nghĩa mọi bề mặt sản phẩm đều có cùng chế độ.
Bốn câu hỏi phải có trong hợp đồng AI
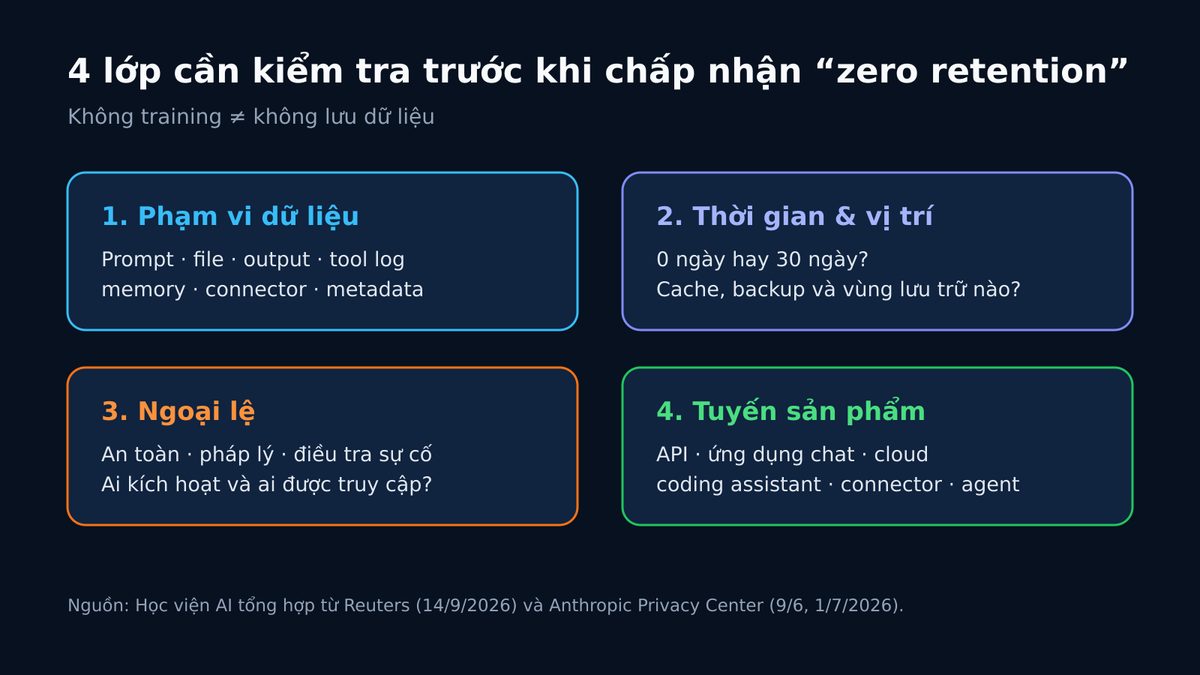
1. Dữ liệu nào được tính? Hợp đồng cần tách prompt, tệp tải lên, output, nhật ký công cụ, bộ nhớ dài hạn, dữ liệu trong connector và metadata vận hành. Nếu chỉ nhắc “customer content”, đội pháp chế phải kiểm tra định nghĩa có bao phủ log của AI Agent hay không.
2. Lưu ở đâu và bao lâu? “Không dùng để training” không phải “không lưu”. Với một quy trình tài chính, pháp lý hoặc an ninh mạng, thời gian lưu 30 ngày và thời gian lưu bằng 0 là hai cấu hình rủi ro khác nhau. Cũng cần biết bản sao dự phòng, cache và hệ thống quan sát có cùng lịch xóa hay không.
3. Ngoại lệ có thể kích hoạt thế nào? Điều khoản thường có ngoại lệ cho chống lạm dụng, tuân thủ luật hoặc điều tra sự cố. Doanh nghiệp nên yêu cầu tiêu chí kích hoạt, người được truy cập, nhật ký kiểm toán và thời điểm thông báo. Không nên mặc định rằng ngoại lệ chỉ tồn tại trên giấy.
4. Cam kết đi theo model hay đi theo sản phẩm? Cùng một mô hình có thể được gọi qua API trực tiếp, nền tảng cloud, ứng dụng chat, công cụ coding hoặc connector của bên thứ ba. Mỗi đường đi tạo ra một chuỗi xử lý dữ liệu khác. Zero-retention cần được kiểm tra trên đúng tuyến triển khai, không chỉ ở tên mô hình.
“Không training” và “zero retention” là hai cổng khác nhau
Một lỗi mua hàng phổ biến là gộp hai câu hỏi thành một. Cổng thứ nhất hỏi dữ liệu có được dùng để cải thiện mô hình hay không. Cổng thứ hai hỏi dữ liệu có tồn tại ở đâu sau khi yêu cầu kết thúc. Cổng thứ ba, thường bị bỏ sót, là dữ liệu có đi qua công cụ phụ, plugin hoặc nhà cung cấp hạ tầng nào trước khi bị xóa hay không.
Khoảng trống này càng lớn với AI Agent. Agent không chỉ đọc một prompt rồi trả lời; nó có thể mở CRM, gửi email, gọi API, tạo file và ghi lại trace của nhiều bước. Vì vậy, checklist triển khai nên nối hợp đồng dữ liệu với kiểm thử vận hành. Khung READY đánh giá AI Agent trước production là một điểm bắt đầu để đưa reliability, oversight và cost vào cùng quyết định. Với rủi ro chuỗi cung ứng, vụ AI Agent dùng RubyGems và hơn 500 gói độc hại cho thấy đường đi của dữ liệu và quyền công cụ cần được quản lý như một hệ thống, không phải một hộp chat.
Nhận định của Học viện AI: kiến trúc đa mô hình sẽ trở thành biện pháp kiểm soát
Nhận định của Học viện AI: Nếu thông tin Reuters dẫn lại phản ánh đúng xu hướng mua hàng, doanh nghiệp lớn sẽ không “cấm AI” toàn bộ. Họ sẽ phân loại workload và định tuyến model: mô hình bên ngoài cho tác vụ ít nhạy cảm, môi trường cô lập hoặc mô hình nội bộ cho dữ liệu lõi, và human approval trước hành động có hậu quả cao.
Cách làm này tạo ra một yêu cầu mới cho đội nền tảng: phải thay model mà không thay toàn bộ quy trình. Nếu prompt, schema công cụ và đánh giá chất lượng bị khóa chặt vào một nhà cung cấp, doanh nghiệp không có đòn bẩy khi điều khoản dữ liệu thay đổi. Kiến trúc đa mô hình vì thế không chỉ để tối ưu chi phí; nó là một lớp quản trị nhà cung cấp.
Doanh nghiệp có thể bắt đầu bằng một bảng phân loại ba tầng. Tầng công khai cho phép nhiều model; tầng nội bộ yêu cầu không training và thời gian lưu giới hạn; tầng bí mật yêu cầu zero-retention đã xác minh, môi trường cô lập, quyền công cụ tối thiểu và log kiểm toán riêng. Với mỗi tầng, cần gắn owner chịu trách nhiệm và phương án dừng sử dụng.
Việc nên làm trong 30 ngày tới
- Lập danh sách mọi tuyến dữ liệu đi vào AI, gồm ứng dụng chat, API, coding assistant, connector và agent.
- Đối chiếu DPA, điều khoản sản phẩm và cấu hình thực tế; không suy luận ZDR từ thông điệp marketing.
- Tách workload theo độ nhạy và cấm dữ liệu lõi ở các tuyến chưa có cam kết phù hợp.
- Thiết kế fallback model hoặc môi trường cô lập cho quy trình không thể dừng.
- Kiểm tra log xóa dữ liệu và quyền truy cập bằng bằng chứng kỹ thuật, không chỉ bằng văn bản hợp đồng.
Nếu doanh nghiệp đang chuẩn hóa AI Agent nhưng chưa có ma trận dữ liệu, quyền và nhà cung cấp, hãy nhận proposal triển khai AI doanh nghiệp từ Học viện AI. Mục tiêu là biến “không dùng dữ liệu để training” thành một cơ chế có thể kiểm chứng, thay vì một câu cam kết khó vận hành.
Nguồn tham khảo
- Reuters, “Palantir, Nvidia curb AI model use over data fears, The Information reports”, 14/9/2026.
- Anthropic Privacy Center, “How long do you store my organization’s data?”, cập nhật 1/7/2026.
- Anthropic Privacy Center, “I have a zero data retention agreement with Anthropic. What products does it apply to?”, cập nhật 9/6/2026.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI
Máy tính ROI khi tự động hoá bằng AI
Nhập một quy trình đang làm tay, biết ngay tự động hoá bằng AI tiết kiệm bao nhiêu mỗi tháng và bao lâu hoàn vốn courseKhoá X10 tốc độ công việc với ChatGPT Work và Claude Cowork
Học cách biến AI từ công cụ hỏi đáp thành hệ thống nhận việc, xử lý nhiều bước và bàn giao thành phẩm.
Nhận thông tin khoá học