Reflection Beam có 501 tỷ tham số, nhưng mỗi token chỉ dùng 23 tỷ
Beam dùng kiến trúc MoE với 501 tỷ tham số tổng, 23 tỷ hoạt động mỗi token. Trọng số chưa phát hành và benchmark chưa được kiểm định độc lập.
Ngày 5/10/2026, Reflection AI công bố Beam — mô hình open-weight dạng Mixture-of-Experts có 501 tỷ tham số tổng nhưng chỉ kích hoạt 23 tỷ tham số cho mỗi token. Khoảng cách giữa hai con số là điểm đáng chú ý nhất: quy mô toàn mạng rất lớn, nhưng chi phí suy luận được kiểm soát bằng cách chỉ gọi một phần “chuyên gia” phù hợp với từng bước xử lý.
Beam được thiết kế cho lập trình, suy luận và tác vụ AI Agent. Tuy nhiên, Reflection vẫn đang chạy đợt red-team cuối cùng; trọng số, model card và báo cáo kỹ thuật chỉ được hứa phát hành trong tháng 10. Vì vậy, đây là một tín hiệu đáng theo dõi chứ chưa phải bằng chứng rằng doanh nghiệp có thể triển khai production ngay hôm nay.
501 tỷ tham số nhưng chỉ 23 tỷ hoạt động nghĩa là gì?
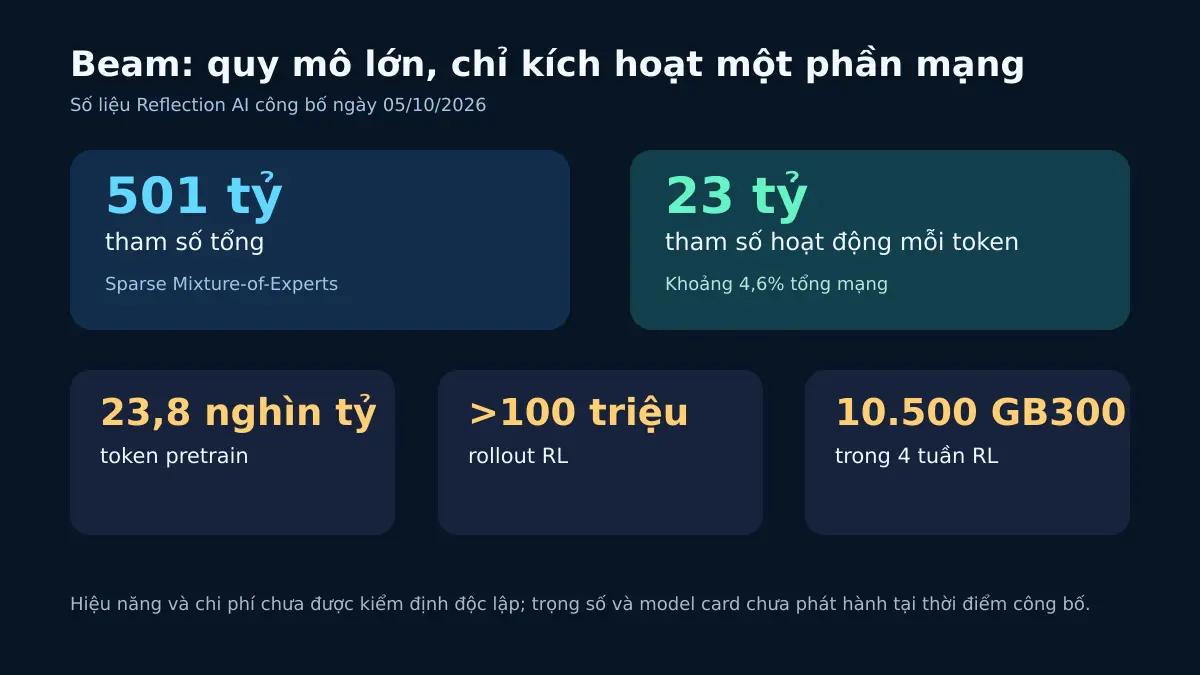
Beam dùng kiến trúc sparse Mixture-of-Experts (MoE). Thay vì kích hoạt toàn bộ mạng cho mỗi token, một bộ định tuyến chọn một nhóm nhỏ “chuyên gia” phù hợp. Theo công bố của Reflection, Beam có 501 tỷ tham số tổng và 23 tỷ tham số hoạt động — tương đương khoảng 4,6% tổng số tham số cho mỗi token.
Thiết kế này không có nghĩa một mô hình 23 tỷ tham số thông thường sẽ cho chất lượng tương đương. Phần không hoạt động ở token hiện tại vẫn tạo nên năng lực chuyên môn tổng thể của mạng. Đổi lại, hiệu quả thật còn phụ thuộc vào cách định tuyến, bộ nhớ, hạ tầng phân tán, độ dài ngữ cảnh và phần mềm suy luận.
23,8 nghìn tỷ token và 100 triệu rollout
Reflection cho biết Beam được pretrain trên 23,8 nghìn tỷ token từ web và dữ liệu được cấp phép. Giai đoạn reinforcement learning tạo hơn 100 triệu rollout trên 10.500 GPU NVIDIA GB300 trong bốn tuần.
Những con số này mô tả quy mô huấn luyện, không tự động chứng minh độ đúng, độ an toàn hay hiệu quả chi phí của một workload cụ thể. Công ty cũng nói Beam có cửa sổ ngữ cảnh 1 triệu token và dùng ít hơn 3–4 lần compute suy luận so với một số đối thủ. TechCrunch lưu ý các tuyên bố hiệu năng này chưa được xác minh độc lập.
Nhận định của Học viện AI: với mô hình MoE, “tham số tổng” ngày càng giống quy mô danh mục năng lực, còn “tham số hoạt động” gần hơn với lượng tính toán dùng cho mỗi token. Nhưng doanh nghiệp không nên dùng tỷ lệ 23/501 làm phép tính trực tiếp cho chi phí. Chi phí còn phụ thuộc tốc độ token, yêu cầu GPU, batching, cache, độ dài prompt và mức sử dụng thực.
Benchmark cho thấy Beam cạnh tranh, chưa dẫn đầu tuyệt đối
Trong bảng do Reflection công bố, Beam đạt 44,4 điểm ở DeepSWE v1.1, gần GLM-5.2 ở mức 44,0. Trên Terminal Bench v2.1, Beam đạt 80,1, thấp hơn GLM-5.2 (81,0), Qwen 3.8 Max (86,6), Kimi K3 (88,3) và DeepSeek V4.1 Flash (90,6). Kết quả này phù hợp hơn với mô tả “mô hình workhorse hiệu quả” thay vì tuyên bố mô hình tốt nhất mọi mặt.
So sánh benchmark giữa các hãng luôn cần thận trọng: prompt, hạ tầng, chế độ suy luận và cách tính điểm có thể khác. Chỉ nên coi bảng hiện tại là dữ liệu của nhà cung cấp cho vòng thử nghiệm đầu tiên.
Open-weight nhưng trọng số chưa mở
Reflection gọi Beam là open-weight và dự kiến phát hành trọng số theo giấy phép Apache 2.0 trong tháng này. Ở thời điểm công bố, người dùng mới có thể đăng ký early access; trọng số, technical report, model card và developer artifacts chưa xuất hiện công khai.
Điểm này quan trọng với doanh nghiệp đang cân nhắc “AI chủ quyền”. Bài Kolibri 78 tỷ tham số: AI chủ quyền nghĩa là gì? đã phân tích rằng quyền tải trọng số chỉ là một lớp. Doanh nghiệp còn phải kiểm soát hạ tầng, dữ liệu, log, bản vá, đội vận hành và quyền thay đổi nhà cung cấp.
Năm câu hỏi trước khi đưa Beam vào thử nghiệm
- Trọng số và giấy phép đã phát hành thật chưa? Không dựa vào lịch hứa nếu yêu cầu hiện tại là tự triển khai.
- Model card có nêu ngôn ngữ, miền dữ liệu và giới hạn an toàn không? Chưa có tài liệu thì chưa thể suy hiệu quả cho tiếng Việt.
- Benchmark nào giống workload của mình? Coding benchmark không đại diện cho CSKH, tài chính hoặc tài liệu pháp lý.
- Chi phí end-to-end là bao nhiêu? Tính GPU, lưu trữ, mạng, quan sát, đội vận hành và bước kiểm tra con người.
- Có kế hoạch rollback và so sánh đối chứng không? Chạy cùng một bộ test trên model hiện tại, Beam và ít nhất một phương án khác.
Bài GPT-6 Sol và Luna giảm 50% giá API cho thấy giá niêm yết thấp không đủ để quyết định. Với model tự host, doanh nghiệp càng cần đo tổng chi phí sở hữu và tỷ lệ đầu ra phải sửa.
Nếu xây AI Agent, lớp model cũng không thay thế sandbox và kiểm soát hành động. Bài NVIDIA cách ly AI Agent trong vài mili-giây là một ví dụ về cách tách model khỏi quyền truy cập hệ thống.
Kết luận
Beam cho thấy cuộc đua open-weight đang chuyển từ “mô hình càng lớn càng tốt” sang “kích hoạt bao nhiêu năng lực cho mỗi token và đổi lấy chất lượng gì”. 501 tỷ tham số tạo chú ý, nhưng quyết định triển khai chỉ nên bắt đầu sau khi trọng số, model card, giấy phép và chi phí suy luận thực tế có thể kiểm chứng.
CTA: Nếu doanh nghiệp cần thiết kế bộ test model theo workload thật, chi phí và rủi ro vận hành, hãy đặt lịch tư vấn 15 phút với Học viện AI.
Nguồn tham khảo
- Reflection AI — Introducing Beam: Reflection’s 501B open-weight model, 05/10/2026.
- Reuters — Nvidia-backed Reflection unveils first AI model, 05/10/2026.
- TechCrunch — Reflection debuts Beam, 05/10/2026.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI