Kolibri 78 tỷ tham số nhưng chỉ 3,46 tỷ hoạt động: “AI chủ quyền” nghĩa là gì?
Kolibri open-weight có 78,1 tỷ tham số, 3,46 tỷ hoạt động mỗi token và giấy phép Apache 2.0. “AI chủ quyền” thực sự đòi hỏi gì?
Aleph Alpha vừa phát hành Kolibri, mô hình AI open-weight song ngữ Đức–Anh có 78,1 tỷ tham số nhưng chỉ kích hoạt 3,46 tỷ tham số cho mỗi token. Cấu trúc Mixture-of-Experts này giúp Kolibri nhắm tới một bài toán rất thực tế: chạy mô hình đủ mạnh trong hạ tầng do doanh nghiệp hoặc cơ quan nhà nước tự kiểm soát, thay vì gửi dữ liệu nhạy cảm tới một API bên ngoài.
Ngày 3/10/2026, Aleph Alpha công bố Kolibri dưới giấy phép Apache 2.0 và đưa trọng số lên Hugging Face. Đây là một tín hiệu đáng chú ý trong cuộc đua “AI chủ quyền” tại châu Âu, nhưng open-weight không đồng nghĩa với open source toàn phần, và nơi đặt máy chủ không tự động biến một hệ thống thành tuân thủ GDPR.
Kolibri có gì bên trong?
Theo bài công bố và thẻ mô hình của Aleph Alpha, Kolibri là Transformer Mixture-of-Experts với 78,1 tỷ tham số tổng, 384 expert và 6 expert được kích hoạt ở mỗi token. Vì vậy, lượng tính toán cho một token gần với mô hình 3,46 tỷ tham số hoạt động, dù toàn bộ trọng số vẫn phải được lưu và phân phối trên phần cứng.
- Ngôn ngữ: Đức và Anh.
- Ngữ cảnh đã huấn luyện dài nhất: 262.144 token; Aleph Alpha nói mô hình có thể mở rộng tới khoảng 1 triệu token, nhưng đây không phải là cùng một mức bảo đảm chất lượng.
- Dữ liệu tiền huấn luyện: 20 nghìn tỷ token ở giai đoạn chính; tổng chuỗi tiền huấn luyện, mid-training và thích nghi ngữ cảnh dài gần 24 nghìn tỷ token.
- Giấy phép: Apache 2.0 cho trọng số được phát hành.
- Hạ tầng huấn luyện: Aleph Alpha cho biết mô hình được xây dựng tại Đức và huấn luyện trên hạ tầng ở Đức, Phần Lan.
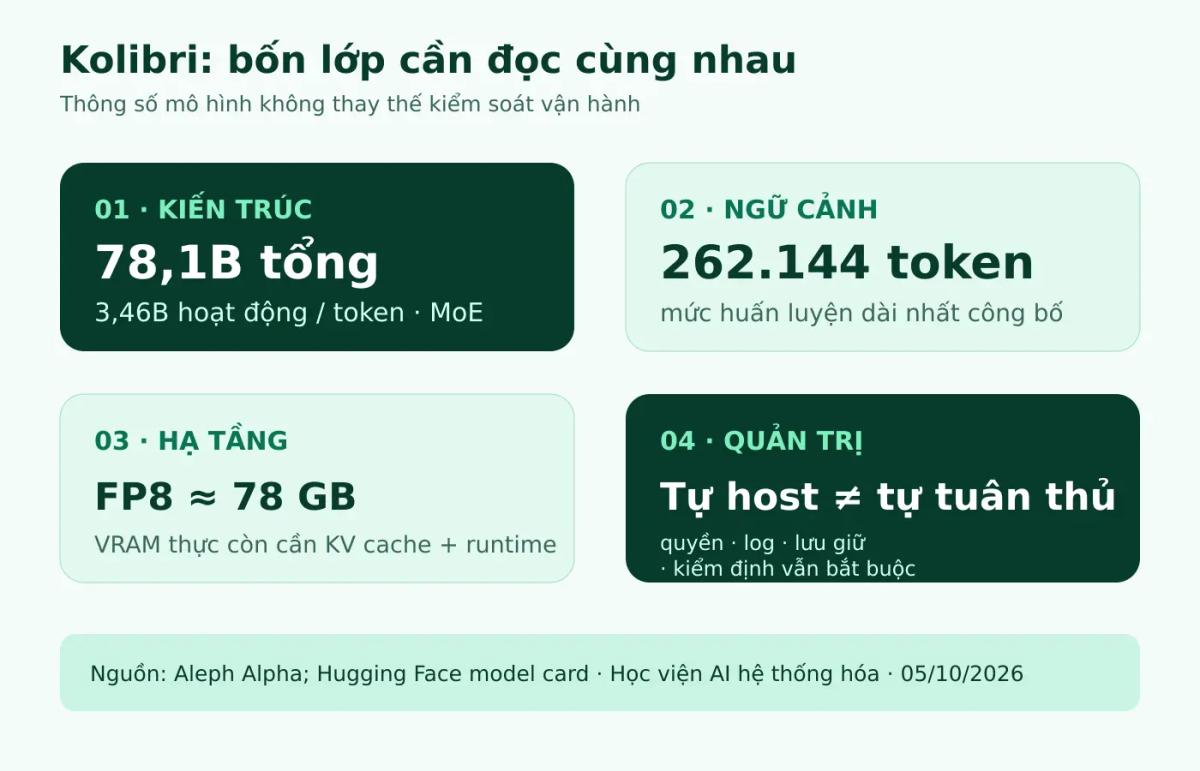
78 tỷ tham số không có nghĩa là 78 tỷ đều chạy cùng lúc
Điểm dễ gây hiểu nhầm nhất là con số 78,1 tỷ. Với MoE, bộ định tuyến chỉ chọn một phần expert phù hợp cho mỗi token. Kolibri kích hoạt 6 trên 384 expert, tương ứng 3,46 tỷ tham số hoạt động mỗi token. Cách thiết kế này giúp giảm chi phí tính toán so với mô hình dense cùng tổng số tham số.
Tuy vậy, doanh nghiệp không nên lấy 3,46 tỷ làm căn cứ duy nhất để dự toán hạ tầng. File trọng số FP8 vẫn vào khoảng 78 GB, còn quá trình suy luận cần thêm bộ nhớ cho KV cache, runtime và ngữ cảnh dài. Thẻ mô hình khuyến nghị tối thiểu hai GPU A100 80 GB hoặc H100 cho cấu hình phổ biến; một H200, B200 hay B300 có thể đủ ở một số cấu hình. Con số thực tế còn phụ thuộc độ dài ngữ cảnh, số người dùng đồng thời và kỹ thuật lượng tử hóa.
Bài học tương tự cũng xuất hiện trong lộ trình Qwen 5–10 nghìn tỷ tham số của Alibaba: quy mô mô hình chỉ là một biến. Hiệu quả mỗi lượt suy luận và khả năng tích hợp vào hạ tầng mới quyết định chi phí vận hành.
“AI chủ quyền” ở đây nghĩa là gì?
Dữ kiện đã xác minh: Aleph Alpha định nghĩa chủ quyền qua quyền kiểm soát chuỗi cung ứng, nơi xây dựng và huấn luyện, khả năng tải trọng số, tự triển khai và tự quyết định dữ liệu đi đâu. Kolibri được phát hành open-weight, cho phép tổ chức chạy on-premise hoặc trong môi trường đám mây do mình chọn.
Nhận định của Học viện AI: đây là điều kiện thuận lợi cho chủ quyền dữ liệu, không phải giấy chứng nhận tuân thủ. Một hệ thống vẫn có thể vi phạm GDPR hoặc chính sách nội bộ nếu ghi log quá mức, giữ dữ liệu quá lâu, cấp quyền sai, dùng dữ liệu không có căn cứ pháp lý hoặc không có quy trình xử lý yêu cầu của chủ thể dữ liệu.
Trường hợp Federal Register dùng Qwen rồi gỡ cho thấy câu hỏi quan trọng không chỉ là mô hình đến từ quốc gia nào, mà còn là dữ liệu được gửi đi đâu, ai vận hành endpoint và ai có quyền truy cập. Tương tự, hướng đi Firefox Smart Window dùng Mistral với cam kết zero-data-retention cho thấy thiết kế lưu giữ dữ liệu là một phần riêng biệt của kiến trúc tin cậy.
Benchmark đáng xem, nhưng chưa đủ để ra quyết định
Aleph Alpha công bố Kolibri đạt 96,9 trên AIME 2025, 84,3 trên GPQA Diamond và 85,9 trên LiveCodeBench v6. Trên một số bài kiểm tra, Kolibri cạnh tranh với các mô hình có nhiều tham số hoạt động hơn. Nhưng đây là kết quả do nhà phát triển tự báo cáo, với thiết lập đánh giá và mô hình so sánh do chính nhà phát triển lựa chọn.
Doanh nghiệp nên coi benchmark công khai là bước lọc đầu tiên. Quyết định triển khai cần thêm bộ test riêng gồm tài liệu nội bộ, câu hỏi buộc mô hình từ chối khi thiếu bằng chứng, ngôn ngữ chuyên ngành, độ trễ ở ngữ cảnh thật và chi phí trên mỗi tác vụ hoàn thành. Đó cũng là cách tránh nhầm “mô hình tốt” với “hệ thống phù hợp”.
Checklist 5 bước trước khi thử Kolibri
- Chốt dữ liệu: phân loại tài liệu nào được phép đưa vào môi trường thử nghiệm.
- Đo VRAM thực: thử đúng ngữ cảnh và số người dùng đồng thời, không chỉ chạy một prompt ngắn.
- Tạo bộ câu hỏi từ chối: kiểm tra khả năng nói “không biết” khi tài liệu không chứa đáp án.
- Ghi nguồn đầu ra: yêu cầu trích đoạn bằng chứng, rồi kiểm tra trích đoạn có thật trong tài liệu.
- So chi phí toàn hệ thống: tính GPU, điện, nhân sự MLOps, bảo mật, cập nhật và giám sát — không chỉ phí token.
Kolibri đáng chú ý vì nó biến “AI chủ quyền” từ khẩu hiệu thành một lựa chọn kỹ thuật cụ thể hơn: trọng số tải được, giấy phép rõ, hạ tầng tự chọn và kiến trúc thưa để giảm chi phí tính toán. Nhưng giá trị thật chỉ xuất hiện khi doanh nghiệp ghép mô hình với quản trị dữ liệu, đánh giá độc lập và quy trình vận hành.
Nguồn tham khảo
- Aleph Alpha — Kolibri Has Landed, 3/10/2026.
- Hugging Face — Aleph-Alpha/Kolibri-1 model card, truy cập 5/10/2026.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI