Federal Register dùng công cụ tìm kiếm dựa trên Qwen rồi gỡ. Rủi ro thật nằm ở dữ liệu, hạ tầng triển khai và quyền kiểm soát.
Website Federal Register của Mỹ đã dùng một công cụ tìm kiếm dựa trên Qwen để tra cứu bình luận công khai về các đề xuất quy định, rồi gỡ công cụ này ngày 17/09/2026. Tranh cãi dễ bị rút gọn thành “cơ quan Mỹ dùng AI Trung Quốc”, nhưng bài toán kỹ thuật thực tế phức tạp hơn: dữ liệu nào đi vào model, model chạy ở đâu và có vượt qua biên kiểm soát của cơ quan hay không?
Sự việc đã được xác nhận đến đâu?
Theo Reuters ngày 17/09/2026, Federal Register — website do Cơ quan Lưu trữ Quốc gia Mỹ vận hành — có một công cụ hỗ trợ người dùng tìm trong các bình luận về quy định liên bang. Công cụ sử dụng Qwen, họ model AI do Alibaba phát triển. Nó được gỡ xuống cùng ngày khi thông tin bắt đầu lan trên mạng xã hội; thời điểm triển khai ban đầu chưa được xác định.
Reuters cho biết Cơ quan Lưu trữ Quốc gia và Nhà Trắng chưa phản hồi yêu cầu bình luận tại thời điểm bài báo được xuất bản. Qwen là model open-weight, nghĩa là tổ chức có thể tải trọng số và chạy trên hạ tầng của mình; việc “dùng Qwen” không tự động có nghĩa dữ liệu được gửi tới máy chủ Alibaba.
Vụ việc diễn ra trong bối cảnh FBI cáo buộc Alibaba sao chép công nghệ Anthropic một cách “malicious”; Đại sứ quán Trung Quốc gọi cáo buộc đó là vô căn cứ. Hai lập trường này là cáo buộc và phản bác chính trị, không tự thân chứng minh luồng dữ liệu hay rủi ro kỹ thuật của công cụ Federal Register.
Rủi ro kỹ thuật nằm ở deployment boundary
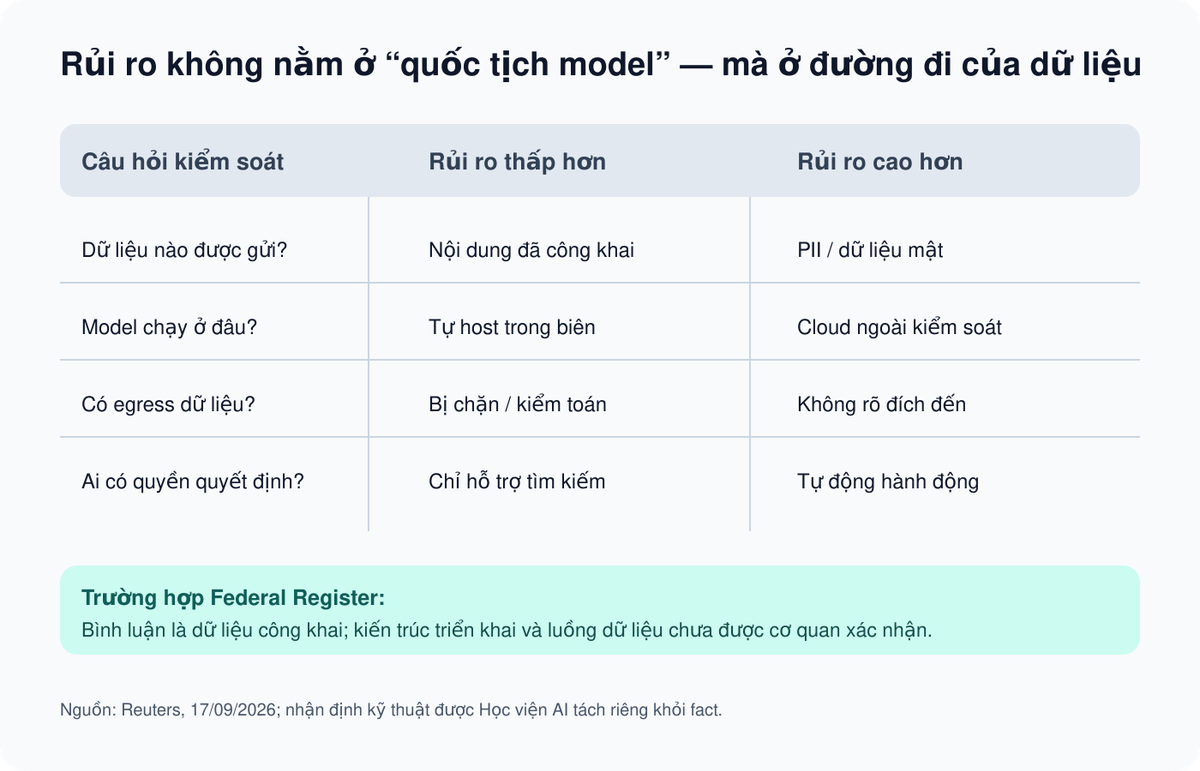
Fact: các bình luận được công cụ xử lý vốn là nội dung công khai. Một chuyên gia luật được Reuters dẫn lời không thấy rủi ro an ninh mạng tức thời, với điều kiện kiến trúc triển khai không đưa thêm dữ liệu nhạy cảm ra ngoài.
Thượng nghị sĩ Mark Warner nhấn mạnh điểm cần kiểm tra là dữ liệu của chính phủ có rời khỏi biên an ninh và được xử lý trên hệ thống do Alibaba kiểm soát hay không. Đây là câu hỏi đúng về mặt kỹ thuật, vì tên model chưa đủ để kết luận.
Một model open-weight có thể được chạy hoàn toàn nội bộ, không gửi prompt ra internet. Ngược lại, một model mang thương hiệu “nội địa” vẫn có thể gây rủi ro nếu được gọi qua dịch vụ bên ngoài, lưu log không rõ ràng hoặc có quyền truy cập quá rộng. Vì vậy, doanh nghiệp nên kiểm toán bốn lớp: nguồn dữ liệu, vị trí inference, luồng egress và quyền hành động.
Dữ liệu công khai không có nghĩa mọi rủi ro đều bằng không
Nếu công cụ chỉ lập chỉ mục và tóm tắt bình luận công khai, rủi ro bảo mật dữ liệu trực tiếp có thể thấp. Tuy nhiên, vẫn còn các câu hỏi khác: kết quả tìm kiếm có thiên lệch không, model có tạo trích dẫn sai không, phiên bản model có được khóa không và nhà vận hành có thể tái lập kết quả khi bị khiếu nại hay không?
Đối với hệ thống công vụ, khả năng giải trình quan trọng không kém độ chính xác trung bình. Một kết quả sai có thể khiến người dùng bỏ sót ý kiến quan trọng trong hồ sơ quy định. Vì vậy, công cụ tìm kiếm AI nên hiển thị tài liệu gốc, đường dẫn và đoạn trích hỗ trợ; không nên biến tóm tắt của model thành nguồn bằng chứng duy nhất.
Nhận định của Học viện AI: quyết định gỡ công cụ có thể phản ánh rủi ro chính sách và niềm tin nhiều hơn rủi ro an ninh đã được chứng minh. Khi cơ quan chưa công bố kiến trúc triển khai, kết luận chắc chắn rằng dữ liệu “đã bị gửi sang Trung Quốc” là vượt quá bằng chứng hiện có.
Bài học cho doanh nghiệp khi chọn model open-weight
Open-weight đem lại quyền kiểm soát lớn hơn, nhưng cũng chuyển trách nhiệm về phía đội vận hành. Doanh nghiệp cần lưu hồ sơ model, license, nguồn trọng số, checksum, phiên bản runtime và chính sách cập nhật. Đây là phần provenance kỹ thuật thường bị bỏ qua khi thử nghiệm nhanh.
Thứ hai, cần xác định chính sách lưu dữ liệu trước khi kết nối model với hệ thống nghiệp vụ. Bài phân tích về Palantir và Nvidia với zero data retention cho thấy “không dùng dữ liệu để huấn luyện” và “không giữ log” là hai cam kết khác nhau; hợp đồng và kiến trúc phải tách bạch chúng.
Thứ ba, provenance của model và dữ liệu huấn luyện vẫn có thể tạo rủi ro pháp lý hoặc uy tín ngay cả khi inference chạy nội bộ. Các cáo buộc về 151 triệu lượt khai thác Claude là lời nhắc rằng nguồn gốc năng lực model đang trở thành vấn đề cạnh tranh và quản trị.
Checklist trước khi đưa AI vào cổng thông tin công khai
- Phân loại dữ liệu: công khai, nội bộ, PII hay bí mật; không cho phép model tự suy diễn phạm vi.
- Vẽ data flow: prompt, log, embedding và telemetry đi đâu; nhà cung cấp nào có thể truy cập.
- Khóa model và phiên bản: mọi thay đổi phải có kiểm thử hồi quy và người phê duyệt.
- Buộc dẫn nguồn: kết quả phải quay về hồ sơ gốc, không chỉ hiển thị câu trả lời tổng hợp.
- Có kill switch: gỡ hoặc vô hiệu hóa tính năng nhanh mà không ảnh hưởng dữ liệu gốc.
Nhận định của Học viện AI: cách đánh giá lành mạnh không phải “model nước nào”, mà là “dữ liệu đi đâu, ai có quyền gì và bằng chứng nào cho thấy hệ thống tuân thủ”. Khung đó áp dụng cho Qwen, Claude, Gemini hay bất kỳ model nào.
Nguồn tham khảo
- Reuters, 17/09/2026 — sự việc Federal Register, Qwen và các phát biểu liên quan.
Cần đánh giá rủi ro dữ liệu trước khi đưa AI vào production? Nhận proposal triển khai AI cho doanh nghiệp từ Học viện AI.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI