Bảng đo 14 ngày cho ChatGPT Dots: thời gian người, phút tiết kiệm, tỷ lệ dùng được lần đầu, rework và run đúng kế hoạch.
ChatGPT Dots có tiết kiệm thời gian không? Câu trả lời không nằm ở số lần Dot báo “đã hoàn tất”, số token hay cảm giác làm việc nhanh hơn. Bạn cần đo thời gian con người thực sự bỏ ra, tỷ lệ đầu ra dùng được, lỗi phải sửa và số lượt chạy đúng kế hoạch.
Bài này cung cấp phép thử 14 ngày, bảng CSV mẫu và công thức minh bạch. Toàn bộ số liệu minh họa chỉ để học cách tính; không phải kết quả đo của Học viện AI, OpenAI hay một doanh nghiệp thật. OpenAI mô tả Dots là agent có thể tiếp tục công việc, dùng nguồn được kết nối và đưa kết quả về cho người dùng, nhưng chính OpenAI cũng lưu ý một run hoàn tất chưa tự chứng minh outcome đã đạt.
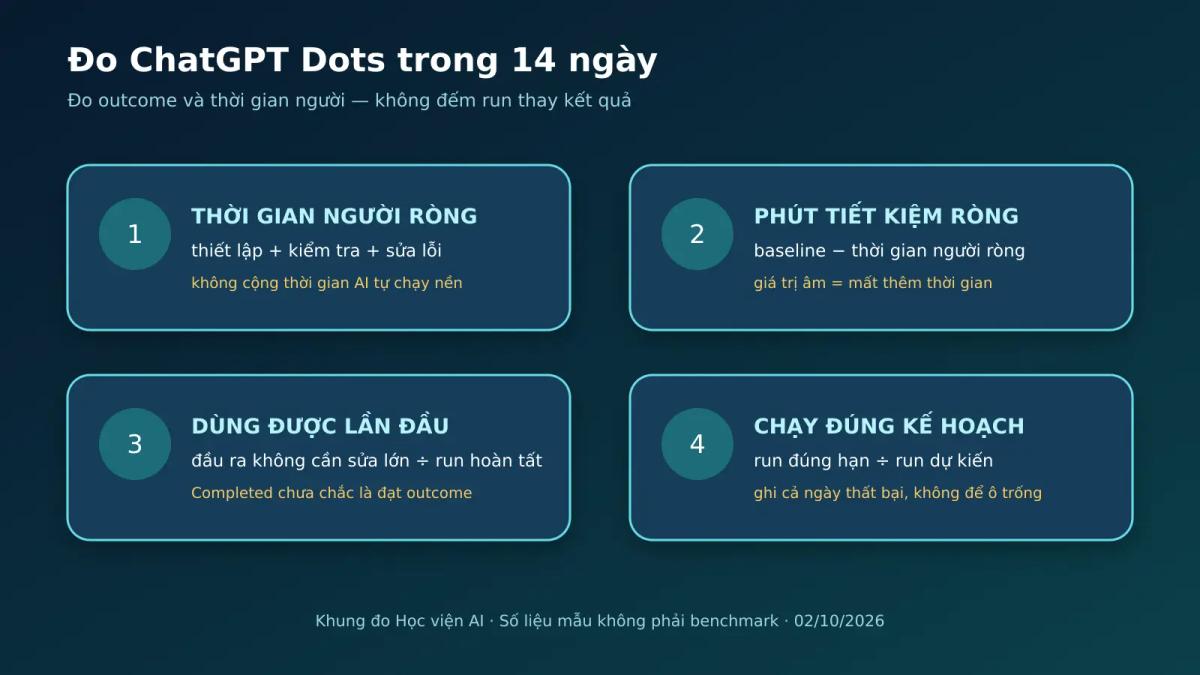
Bốn chỉ số đủ dùng cho phép thử đầu tiên
| Chỉ số | Công thức | Ý nghĩa | Không được nhầm với |
|---|---|---|---|
| Thời gian người ròng | Thiết lập + kiểm tra + sửa lỗi | Số phút nhân sự thực sự phải bỏ ra | Thời gian Dot tự chạy nền |
| Phút tiết kiệm ròng | Baseline thủ công − thời gian người ròng | Chênh lệch trên cùng một loại việc | Thời gian “ước chừng” sau khi đã biết kết quả |
| Tỷ lệ dùng được lần đầu | Số đầu ra dùng được không sửa lớn ÷ số run hoàn tất | Chất lượng ở lần bàn giao đầu | Tác vụ báo Completed |
| Tỷ lệ chạy đúng kế hoạch | Số run hoàn tất đúng hạn ÷ số run dự kiến | Độ ổn định của lịch và nguồn | Số lịch đã tạo |
Ghi thêm rework và lỗi lớn để tránh nghịch lý: một workflow tạo nháp trong hai phút nhưng khiến người dùng mất 25 phút kiểm và sửa thì chưa chắc tiết kiệm thời gian.
Chọn một việc lặp, không đo “mọi thứ Dot làm”
Chọn một outcome có đầu vào và tiêu chí ổn định, ví dụ bản tin công việc mỗi sáng, brief họp tuần hoặc bảng phân nhóm phản hồi. Không trộn ba loại việc vào một chỉ số trung bình. Nếu độ khó thay đổi mạnh, đánh dấu riêng thay vì kết luận do Dot tốt lên hoặc kém đi.
Ví dụ phép thử trong bài:
- Việc: tạo bản tin sáng từ cùng ba nguồn đã được chỉ định.
- Đầu ra đạt: đủ ba mục ưu tiên, có nguồn, không đổi trạng thái đề xuất thành quyết định.
- Lỗi lớn: sai số, bỏ nguồn bắt buộc, gửi sai nơi hoặc tạo hành động ngoài phạm vi.
- Đơn vị đo: phút người; không cộng thời gian AI chạy nền nếu người không phải chờ chủ động.
Thiết kế 14 ngày không tự đánh lừa mình
Ngày 1–3: đo baseline thủ công
Làm việc như bình thường và bấm giờ từ lúc mở nguồn đến khi đầu ra sẵn sàng sử dụng. Ghi ba lần để tránh lấy một ngày quá dễ hoặc quá khó làm chuẩn. Baseline dùng cho từng loại việc nên là trung vị hoặc trung bình có giải thích; đừng chọn con số đẹp nhất.
Ngày 4–6: chạy có giám sát
Cho ChatGPT Dots làm cùng việc, nhưng chưa mở rộng phạm vi. Ghi riêng thời gian thiết lập prompt, thời gian kiểm, thời gian sửa và lỗi lớn. Mở Activity để xem run, nguồn và yêu cầu đang chờ. Nếu có lịch, xác nhận trong Scheduled thay vì chỉ tin câu trả lời trong chat.
Ngày 7–14: giữ cấu hình đủ ổn định
Chỉ thay một biến mỗi lần, chẳng hạn thêm tiêu chí nguồn hoặc sửa nơi giao. Nếu đổi nguồn, prompt, người kiểm và tiêu chí cùng lúc, bạn sẽ không biết yếu tố nào tạo chênh lệch. Ghi cả ngày run không xảy ra; đó là dữ liệu độ ổn định, không phải ô trống.
Bảng theo dõi CSV có thể sao chép
Tải hoặc sao chép bảng theo dõi ChatGPT Dots 14 ngày. File có 14 dòng minh họa, công thức thời gian người và phút tiết kiệm. Khi dùng thật, thay toàn bộ số mẫu bằng số đo của bạn và giữ nguyên cột ghi chú.
Ngay,Cong_viec,Che_do,Run_du_kien,Run_dung_han,Baseline_phut,Thiet_lap_phut,Kiem_tra_phut,Sua_loi_phut,Loi_lon,Dung_duoc_lan_dau,Thoi_gian_nguoi,Phut_tiet_kiem,Ghi_chu
2026-10-01,Ban tin sang,Thu cong,1,1,32,0,32,0,0,1,32,0,Du lieu minh hoa
2026-10-04,Ban tin sang,Dots,1,1,31,5,8,2,0,1,15,16,Du lieu minh hoa
Hai dòng trên chỉ giải thích cấu trúc. File đầy đủ chứa đủ 14 ngày và dòng tổng hợp. Nếu phần mềm bảng tính của bạn dùng dấu chấm phẩy thay dấu phẩy, hãy chọn đúng delimiter khi nhập.
Cách tính từ bảng
- Thời gian người mỗi run:
Thiet_lap_phut + Kiem_tra_phut + Sua_loi_phut. - Phút tiết kiệm mỗi run:
Baseline_phut - Thoi_gian_nguoi. Giá trị âm nghĩa là mất thêm thời gian. - Tổng phút tiết kiệm: cộng cột
Phut_tiet_kiemcho các dòng Dots có việc tương đương. - Tỷ lệ dùng được lần đầu: tổng
Dung_duoc_lan_dauchia cho số run Dots hoàn tất. - Tỷ lệ chạy đúng kế hoạch: tổng
Run_dung_hanchia tổngRun_du_kien. - Tỷ lệ rework: tổng
Sua_loi_phutchia tổngThoi_gian_nguoi.
Không quy đổi thành tiền nếu chưa có chi phí lao động, chi phí công cụ và quy tắc phân bổ được duyệt. “Tiết kiệm 120 phút” không tự động bằng ROI dương.
Prompt chốt tiêu chí trước khi đo
“Trong 11 lượt tiếp theo, hãy thực hiện đúng một việc: tạo bản tin sáng từ các nguồn S1–S3. Mỗi đầu ra phải có thời điểm kiểm, danh sách nguồn đã đọc, ba ưu tiên, khoảng trống dữ liệu và việc cần tôi quyết định. Không tự điền dữ kiện thiếu, không gửi ra ngoài và không sửa nguồn. Nếu một nguồn lỗi, vẫn làm phần còn đủ nhưng ghi rõ mã nguồn và lỗi. Trả trong cuộc trò chuyện này. Xác nhận lịch, múi giờ, ngày kết thúc và nơi giao. Sau mỗi run, nêu thời điểm bắt đầu/kết thúc và yêu cầu đang chờ để tôi ghi vào bảng đo.”
Prompt giúp chuẩn hóa đầu ra, nhưng số phút phải do người đo ghi lại. Đừng yêu cầu Dot tự chấm “tôi đã tiết kiệm bao nhiêu thời gian” rồi dùng câu trả lời đó làm dữ liệu.
Ví dụ đọc kết quả mà không thổi phồng
Giả sử dữ liệu minh họa cho thấy baseline trung bình 31 phút, còn thời gian người khi dùng Dots là 15 phút ở phần lớn lượt chạy. Bạn có thể nói: “Trong bộ dữ liệu minh họa, chênh lệch là 16 phút mỗi lượt tương đương; cần thay bằng số đo thật trước khi kết luận.”
Nếu 9/11 run đúng hạn nhưng chỉ 6 đầu ra dùng được lần đầu, vấn đề ưu tiên là chất lượng và rework, không phải tạo thêm lịch. Nếu 11/11 đầu ra tốt nhưng chỉ 7 run xuất hiện đúng giờ, hãy chẩn đoán Scheduled, quyền nguồn và notification. Bài ChatGPT Dots không chạy lịch cung cấp cây kiểm tương ứng.
Khi nào nên mở rộng và khi nào nên dừng?
| Tín hiệu | Quyết định thử nghiệm |
|---|---|
| Thời gian người giảm, lỗi lớn không tăng, run ổn định | Mở rộng thêm một loại nguồn hoặc một người dùng |
| Tiết kiệm thời gian nhưng rework cao | Giữ phạm vi, sửa tiêu chí đầu ra và bước kiểm |
| Đầu ra tốt nhưng lịch hay thiếu | Sửa vận hành Scheduled/kết nối trước |
| Có lỗi lớn liên quan gửi, sửa hoặc dữ liệu nhạy cảm | Dừng mở rộng, thu hẹp quyền và nghiệm thu lại |
| Thời gian người không giảm sau giai đoạn học | Xem lại loại việc; không ép tự động hóa chỉ để giữ dự án |
Ngưỡng “đạt” phải do đội của bạn đặt trước khi nhìn kết quả. Một tác vụ rủi ro cao có thể yêu cầu không có lỗi lớn; một tác vụ nghiên cứu nội bộ có thể chấp nhận nhiều rework hơn.
Sáu lỗi đo phổ biến
- Đếm thời gian AI chạy nền như thời gian người: chỉ tính khi con người phải chờ hoặc can thiệp.
- So việc dễ của Dots với việc khó làm tay: phải cùng loại outcome và nguồn.
- Bỏ ngày thất bại: run không xuất hiện là dữ liệu độ ổn định.
- Không tính thời gian kiểm: đây thường là chi phí lớn nhất.
- Dùng Completed thay cho đầu ra đạt: OpenAI yêu cầu vẫn kiểm kết quả và lỗi sau run.
- Kết luận ROI từ 14 ngày: phép thử nhỏ chỉ hỗ trợ quyết định tiếp tục, sửa hay dừng; chưa đủ để khái quát toàn doanh nghiệp.
Đọc tiếp và thực hành
Nếu chưa có workflow ổn định, đọc cách giao việc đầu tiên cho OpenAI Dots. Để đo một lịch cụ thể, tham khảo mẫu bản tin công việc mỗi sáng. Trước khi mở rộng, dùng ma trận quyền ChatGPT Dots. Muốn có thêm quy trình đóng gói theo vai trò, tải Kho 98 Skills AI miễn phí.
Nguồn và giới hạn
- OpenAI — Introducing dots, truy cập 02/10/2026.
- OpenAI — Meet dots, truy cập 02/10/2026.
- OpenAI — Get started with your dot, truy cập 02/10/2026.
- OpenAI — Tasks and memory, truy cập 02/10/2026.
- OpenAI — Control your dot, truy cập 02/10/2026.
Khung 14 ngày, tên cột, công thức và số liệu mẫu trong bài là phương pháp của Học viện AI, không phải benchmark hay cam kết hiệu quả của OpenAI. Tính năng Dots có thể khác theo gói, khu vực, workspace, vai trò và đợt rollout.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI
Khoá X10 tốc độ công việc với ChatGPT Work và Claude Cowork
Học cách biến AI từ công cụ hỏi đáp thành hệ thống nhận việc, xử lý nhiều bước và bàn giao thành phẩm.
Nhận thông tin khoá học lead_magnetMáy tính ROI khi tự động hoá bằng AI
Nhập một quy trình đang làm tay, biết ngay tự động hoá bằng AI tiết kiệm bao nhiêu mỗi tháng và bao lâu hoàn vốn lead_magnet98 Skills AI + 30 case ChatGPT Work miễn phí
Bộ kỹ năng và case thực chiến để bắt đầu dùng AI vào công việc ngay.
Nhận miễn phí