Oxford chia sẻ 125.000 ảnh luận án cho OpenAI: đọc đúng phạm vi dữ liệu
Bodleian Library đã chia sẻ 125.000 ảnh luận án trong hợp tác OpenAI. Bài viết tách dữ kiện đã xác minh khỏi suy diễn về toàn bộ 23 triệu hiện vật.
Oxford chia sẻ 125.000 ảnh luận án cho OpenAI: đọc đúng phạm vi dữ liệu
Tóm tắt: Tài liệu nội bộ được The Guardian tiếp cận cho thấy dữ liệu lịch sử từ Bodleian Library đã được dùng để bổ sung tập huấn luyện của OpenAI. Oxford nói dự án chỉ dùng tài liệu hết hạn bản quyền, quy mô khiêm tốn, không độc quyền và thư viện vẫn giữ quyền với bản số hóa.
Những con số đã được xác minh
University of Oxford công bố quan hệ hợp tác với OpenAI từ tháng 3/2025, với mục tiêu dùng công nghệ để số hóa tài liệu lịch sử của Bodleian Library và mở rộng khả năng tiếp cận cho sinh viên, nhà nghiên cứu. Bài công bố ban đầu nhấn mạnh số hóa; yếu tố dữ liệu huấn luyện không được trình bày nổi bật.
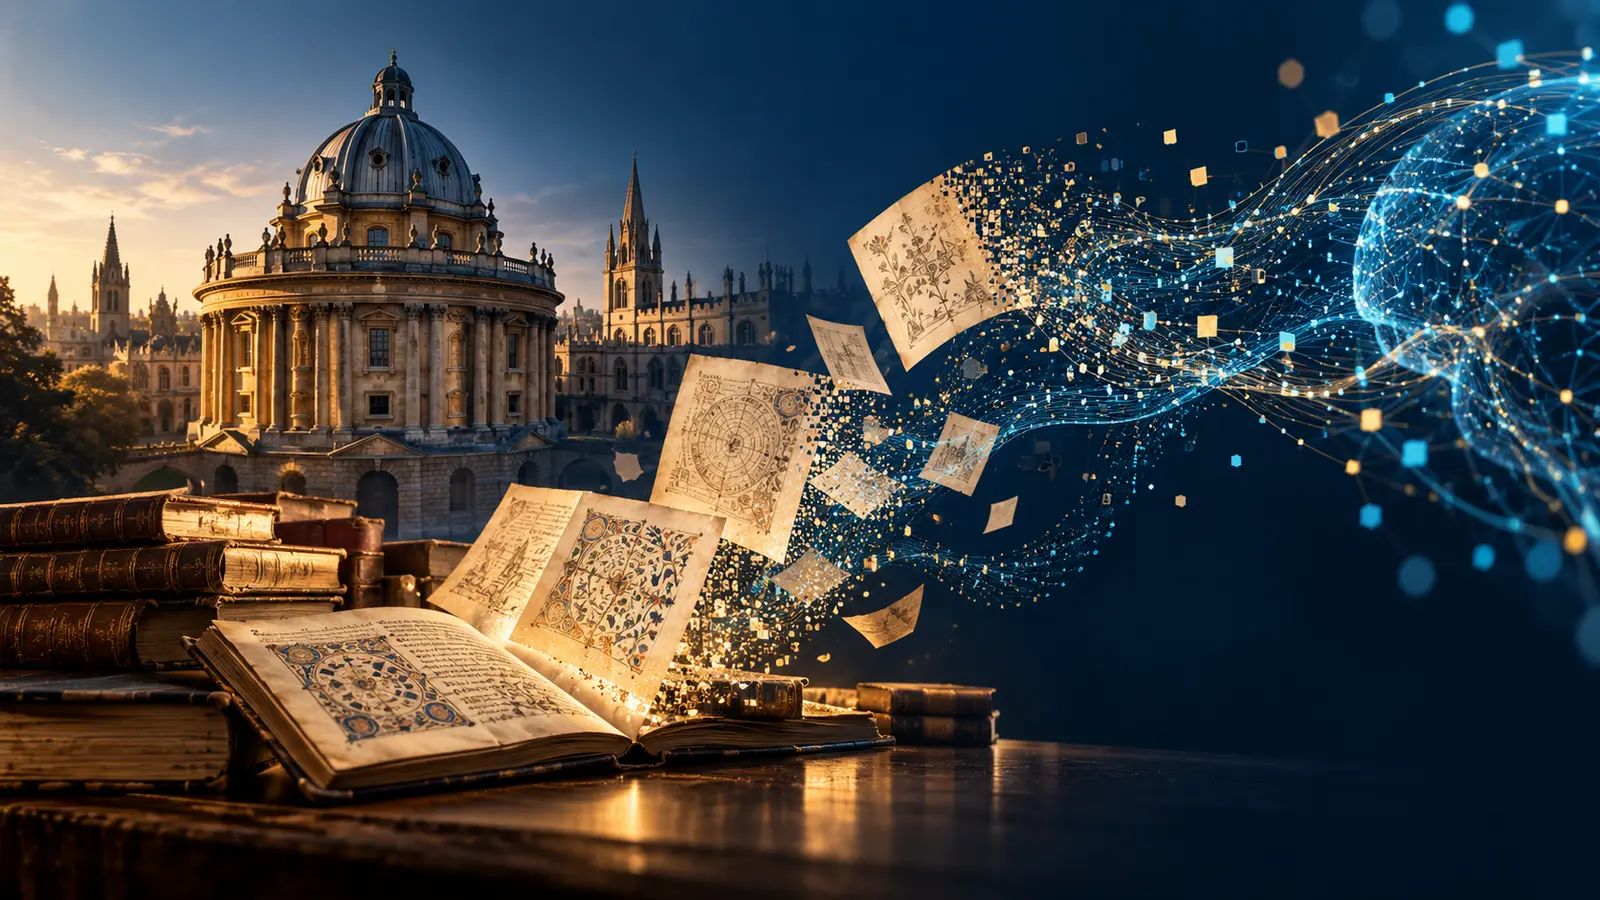
The Guardian ngày 26/09/2026 dẫn biên bản họp nội bộ và hồ sơ có được qua yêu cầu tự do thông tin. Theo đó, tài liệu số hóa đã được dùng để “bổ sung” tập huấn luyện OpenAI. Đến tháng 6/2025, 125.000 ảnh quét từ các luận án lịch sử đã được chia sẻ, gồm luận án của nhiều đại học châu Âu và Mỹ trong thế kỷ 19–20.
Một nhóm khác là 10.000 “broadside ballad” từ thế kỷ 16 — các tờ in đơn có lời hát và ký âm từng được lưu hành trên đường phố thời Tudor. Nhân sự Oxford cũng đã thảo luận khả năng số hóa giấy tờ nhà nước Ireland thế kỷ 18, thư riêng của tiểu thuyết gia Maria Edgeworth và sổ tay nghiên cứu penicillin của Dorothy Hodgkin.
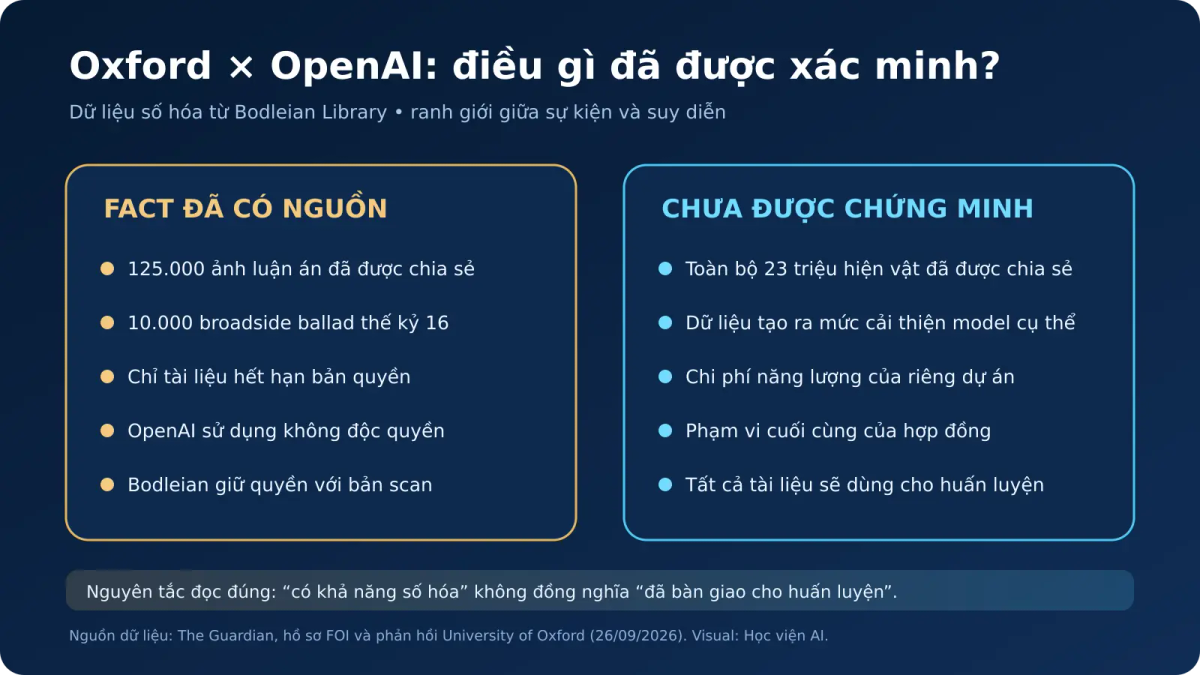
23 triệu hiện vật không có nghĩa 23 triệu đã được bàn giao
Bodleian Libraries có bộ sưu tập khoảng 23 triệu hiện vật. Biên bản được The Guardian dẫn nói hợp đồng mở ra khả năng số hóa quy mô lớn và từng thảo luận một chatbot “Ask the Bod”. Nhưng “khả năng” không phải trạng thái đã hoàn tất.
Con số 23 triệu vì vậy không nên được viết thành “OpenAI đã nhận 23 triệu tài liệu”. Dữ kiện cụ thể được công bố là 125.000 ảnh luận án cùng nhóm 10.000 ballad đã được số hóa; phạm vi cuối cùng của các bộ sưu tập khác chưa có số liệu hoàn tất trong nguồn.
Phản hồi của Oxford cũng đặt ra bốn giới hạn: lượng tài liệu được mô tả là khiêm tốn; chỉ gồm tài liệu hết hạn bản quyền; việc OpenAI sử dụng không độc quyền; Bodleian giữ quyền với bản scan và dự kiến công bố mở các tài liệu trong những tháng tới.
Fact, tranh luận và nhận định của Học viện AI
Fact: dự án có mục tiêu số hóa và tạo dữ liệu cho OpenAI; các con số 125.000 ảnh và 10.000 ballad được ghi nhận; Oxford khẳng định tài liệu nằm ngoài bản quyền và thư viện giữ quyền với bản số hóa.
Tranh luận nội bộ: biên bản họp ghi nhận lo ngại của nhân sự về rủi ro danh tiếng và tác động tới cam kết môi trường khi hợp tác với một công nghệ tiêu thụ nhiều năng lượng. Nêu lo ngại không đồng nghĩa dự án đã được chứng minh gây ra một mức phát thải cụ thể; nguồn không cung cấp phép đo năng lượng riêng cho hợp tác này.
Nhận định của Học viện AI: giá trị của thỏa thuận nằm ở “dữ liệu sạch về nguồn gốc”: tài liệu lịch sử có quyền sử dụng rõ hơn, ít lẫn nội dung AI tổng hợp và chứa ngôn ngữ, bối cảnh văn hóa hiếm. Đổi lại, tổ chức nắm dữ liệu phải công khai mục đích sử dụng, phạm vi cấp phép, cơ chế truy cập công cộng và cách đánh giá lợi ích xã hội.
Năm câu hỏi mọi tổ chức nên hỏi trước khi cấp dữ liệu cho AI
- Quyền: ai sở hữu bản gốc, bản scan, metadata và các đầu ra phái sinh?
- Phạm vi: dữ liệu được dùng cho số hóa, tìm kiếm, fine-tuning hay pre-training?
- Độc quyền: đối tác có quyền sử dụng riêng hay tổ chức vẫn được công bố và cấp phép cho bên khác?
- Khả năng truy nguyên: có sổ đăng ký bộ dữ liệu, ngày bàn giao, phiên bản và điều kiện loại bỏ hay không?
- Lợi ích công: sau hợp tác, người học và nhà nghiên cứu có thực sự tiếp cận tài liệu tốt hơn không?
Các câu hỏi này tương đồng với bài toán doanh nghiệp đang gặp khi đàm phán zero-data-retention và phạm vi lưu dữ liệu AI. “Không dùng để huấn luyện” chỉ là một điều khoản; vẫn phải làm rõ metadata, bản sao dự phòng, ngoại lệ an toàn và trách nhiệm khi dữ liệu đi sai phạm vi.
Tại sao dữ liệu lịch sử trở nên chiến lược?
Nội dung công khai trên web ngày càng lẫn văn bản do AI tạo. Dữ liệu từ thư viện có ba đặc điểm đáng giá: có nguồn gốc xác định, độ hiếm cao và cấu trúc thời gian dài. Với model, đó là nguồn bổ sung cho các ngữ cảnh văn hóa hoặc ngôn ngữ không hiện diện nhiều trên web hiện đại.
Nhưng “hiếm” không tự động đồng nghĩa “được phép”. Tổ chức cần tách bản quyền tác phẩm, quyền đối với bản scan, dữ liệu cá nhân có thể còn tồn tại trong tài liệu và điều kiện truy cập. Case Oxford cho thấy một thỏa thuận hợp pháp vẫn có thể tạo tranh luận nếu thông tin về mục đích huấn luyện không được truyền thông đủ rõ từ đầu.
Cách tiếp cận phù hợp là tạo một hồ sơ provenance có thể kiểm toán, tương tự yêu cầu doanh nghiệp lưu dấu vết khi AI Agent tự ý mở rộng hành động. Với dữ liệu, hồ sơ cần trả lời: tài liệu đến từ đâu, ai phê duyệt, được dùng trong phiên bản nào và khi nào quyền sử dụng hết hiệu lực.
Kết luận
Hợp tác Oxford–OpenAI không nên bị rút gọn thành hai cực “bảo tồn tri thức” hoặc “trao kho sách cho AI”. Dữ liệu hiện có cho thấy lợi ích số hóa là thật, mục đích huấn luyện cũng là thật, còn phạm vi 23 triệu hiện vật mới là khả năng chứ chưa phải khối lượng đã bàn giao.
Nếu tổ chức cần xây chính sách dữ liệu AI, Source Register, điều khoản nhà cung cấp và quy trình phê duyệt tập dữ liệu có thể kiểm toán, hãy nhận proposal triển khai AI thực chiến từ Học viện AI.
Nguồn tham khảo
- The Guardian — Oxford lets OpenAI train its AI models on Bodleian Library, 26/09/2026.
- Bodleian Libraries — Oxford and OpenAI launch collaboration, 04/03/2025.
Phương pháp: Bài viết dùng các con số The Guardian dẫn từ hồ sơ FOI và tách riêng phản hồi chính thức của Oxford; không suy rộng quy mô toàn bộ 23 triệu hiện vật thành dữ liệu đã chuyển giao.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI