MediaTek ra chip 2 nm: đọc đúng mức tăng 51% cho AI trên thiết bị
MediaTek ra Dimensity 9600 Pro trên quy trình 2 nm và công bố NPU tăng 51% ở bước xử lý prompt. Bài viết tách rõ benchmark sản phẩm với dữ liệu nền tảng TSMC N2.
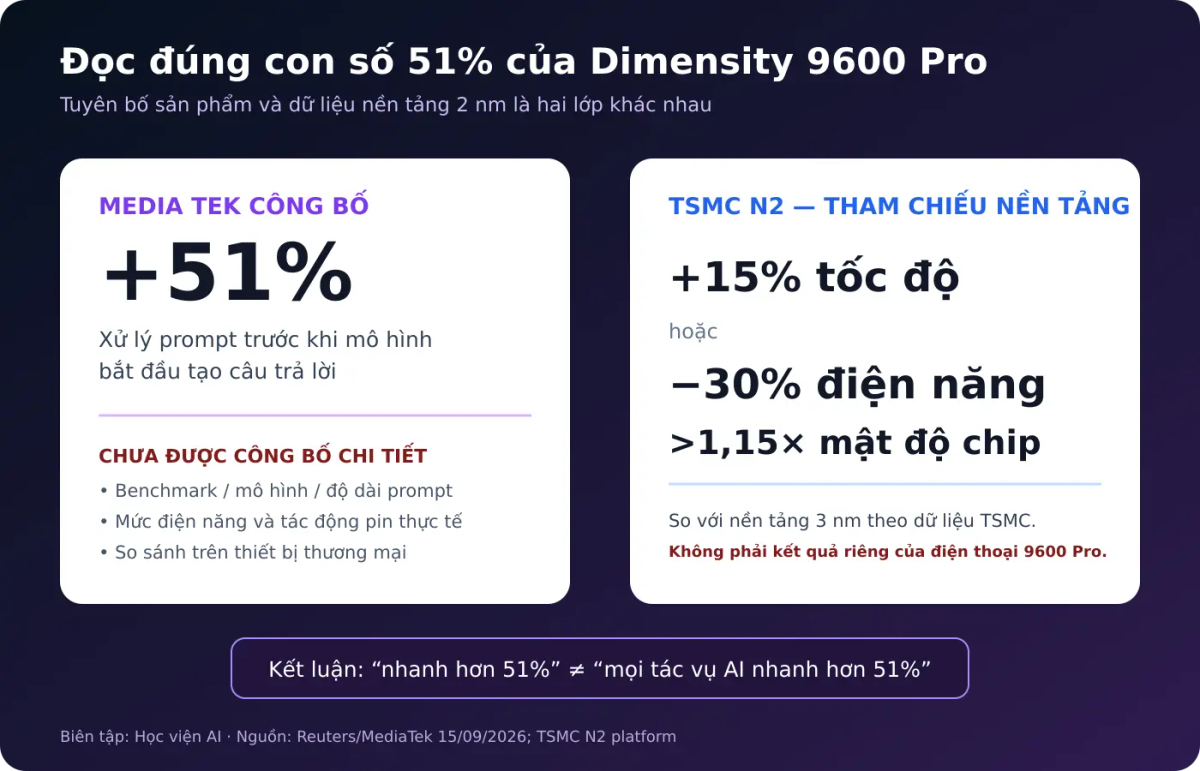
Fact: MediaTek ngày 15/09/2026 giới thiệu Dimensity 9600 Pro, bộ xử lý di động đầu tiên của hãng dùng quy trình 2 nanomet của TSMC. MediaTek nói NPU trên chip cải thiện 51% ở bước xử lý prompt trước khi mô hình AI bắt đầu tạo câu trả lời. Hãng không công bố thêm chi tiết benchmark trong thông tin Reuters tiếp cận.
Con số 51% dễ trở thành tiêu đề “AI trên điện thoại nhanh hơn một nửa”, nhưng đó là cách đọc quá rộng. Phép đo chỉ nhắm vào một giai đoạn của pipeline suy luận. Dù vậy, nó vẫn phản ánh một chuyển dịch quan trọng: ngày càng nhiều tác vụ AI sẽ được xử lý ngay trên thiết bị thay vì gửi toàn bộ dữ liệu lên cloud.
Dimensity 9600 Pro và 9600M khác nhau ở đâu?
Theo Reuters, Dimensity 9600 Pro là chip di động đầu tiên của MediaTek được sản xuất trên quy trình 2 nm của TSMC. Cùng đợt, hãng giới thiệu Dimensity 9600M dùng quy trình 3 nm cho phân khúc flagship rộng hơn. Những điện thoại đầu tiên sử dụng hai chip sẽ ra mắt “sớm”, nhưng MediaTek chưa nêu model máy và lịch bán cụ thể trong thông tin được công bố.
MediaTek nói 9600 Pro có bộ xử lý thần kinh chuyên dụng để chạy các ứng dụng tạo sinh phức tạp hơn trên điện thoại. NPU được công bố tăng 51% hiệu năng xử lý prompt trước giai đoạn mô hình sinh phản hồi so với thế hệ trước. Nguồn không cho biết mô hình, độ dài prompt, bộ dữ liệu, mức điện năng hay cấu hình thiết bị dùng cho phép đo.
2 nm mang lại gì — và chưa nói được gì?
Trong tài liệu kỹ thuật về nền tảng N2, TSMC cho biết công nghệ nanosheet 2 nm có thể đạt mức tăng tốc 15% hoặc giảm điện năng 30%, đồng thời tăng mật độ chip hơn 1,15 lần so với thế hệ 3 nm. Đây là chỉ tiêu của nền tảng bán dẫn dưới các điều kiện thiết kế tham chiếu, không phải cam kết rằng một chiếc điện thoại sẽ nhanh hơn 15% hoặc pin lâu hơn 30%.
Hiệu năng sản phẩm cuối còn phụ thuộc kiến trúc CPU, GPU, NPU, bộ nhớ, phần mềm, giới hạn nhiệt và cách hãng điện thoại cấu hình. Chip 2 nm tạo thêm “ngân sách” hiệu năng và điện năng; nhà sản xuất có thể dùng ngân sách đó để tăng tốc, kéo dài pin, chạy model lớn hơn hoặc cân bằng cả ba.
Nhận định của Học viện AI: Ý nghĩa của 2 nm với AI không chỉ là điểm benchmark cao hơn. AI chạy trên thiết bị bị giới hạn bởi nhiệt, pin và băng thông bộ nhớ. Khi hiệu quả năng lượng cải thiện, smartphone có thể giữ tác vụ AI hoạt động lâu hơn, phản hồi nhanh hơn và bớt phụ thuộc vào kết nối mạng.
Tại sao on-device AI đáng quan tâm với doanh nghiệp?
Dữ liệu không nhất thiết phải rời thiết bị
Tóm tắt cuộc gọi, xử lý ảnh, phân loại nội dung hoặc gợi ý văn bản có thể diễn ra cục bộ khi model phù hợp. Điều này giảm một phần rủi ro gửi dữ liệu nhạy cảm ra ngoài. Nó không tự động tạo ra bảo mật: ứng dụng vẫn có thể thu thập dữ liệu, model vẫn có thể bị khai thác và kết quả vẫn cần quyền truy cập đúng.
Độ trễ thấp hơn cho những tương tác tức thời
Khi không phải chờ round trip tới máy chủ, trợ lý giọng nói, dịch trực tiếp, chỉnh ảnh hay trợ năng có thể phản hồi nhanh hơn. Lợi ích đặc biệt rõ trong môi trường mạng yếu hoặc khi nhiều yêu cầu nhỏ xảy ra liên tục.
Chi phí cloud có thể giảm, nhưng chuyển sang chi phí thiết bị
Mỗi tác vụ chạy tại chỗ là một tác vụ không phải trả inference trên cloud. Tuy nhiên, doanh nghiệp phải hỗ trợ nhiều cấu hình phần cứng, tối ưu model, kiểm thử pin và quản lý phiên bản. Với hệ thống lai, cần quy tắc rõ tác vụ nào chạy local, tác vụ nào chuyển cloud và khi nào người dùng được thông báo.
Đừng biến 51% thành lời hứa sai
Con số MediaTek công bố chỉ đo bước tiền xử lý prompt. Nó không chứng minh mọi model tạo câu trả lời nhanh hơn 51%, cũng chưa cho biết chất lượng đầu ra, token/giây hay điện năng tiêu thụ. Cách truyền thông thận trọng là ghi đúng phạm vi phép đo và chờ benchmark độc lập trên điện thoại thương mại.
Đây là lý do cần phân biệt năng lực hạ tầng với outcome người dùng. Câu chuyện ASML High NA và nút thắt sản xuất chip AI cho thấy công nghệ quy trình tiên tiến phụ thuộc cả chuỗi cung ứng. Ở phía sử dụng, yêu cầu zero-data-retention của Palantir và Nvidia cho thấy doanh nghiệp quan tâm dữ liệu đi đâu không kém model mạnh đến đâu. Trong khi đó, các campus cloud quy mô lớn như TCS HyperVault 1 GW nhắc rằng on-device và cloud sẽ cùng tồn tại, không loại trừ nhau.
Nhận định của Học viện AI: Bài toán tốt nhất cho doanh nghiệp không phải “đưa mọi AI xuống điện thoại”, mà là phân loại tác vụ theo độ nhạy dữ liệu, độ trễ, độ phức tạp và chi phí. Tác vụ riêng tư, ngắn và lặp lại có thể ưu tiên local; tác vụ cần model lớn, dữ liệu chung hoặc phối hợp nhiều hệ thống vẫn phù hợp với cloud.
Doanh nghiệp muốn thiết kế kiến trúc AI lai giữa thiết bị và cloud, kèm ma trận dữ liệu và chi phí, có thể nhận proposal tư vấn từ Học viện AI.
Nguồn tham khảo
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI