CoreWeave đưa Vera Rubin vào production: Devin tăng 4,8 lần thông lượng token
CoreWeave đưa Vera Rubin vào production; Cognition báo thông lượng token tăng tới 4,8 lần và sandbox khởi động nhanh hơn 3 lần.
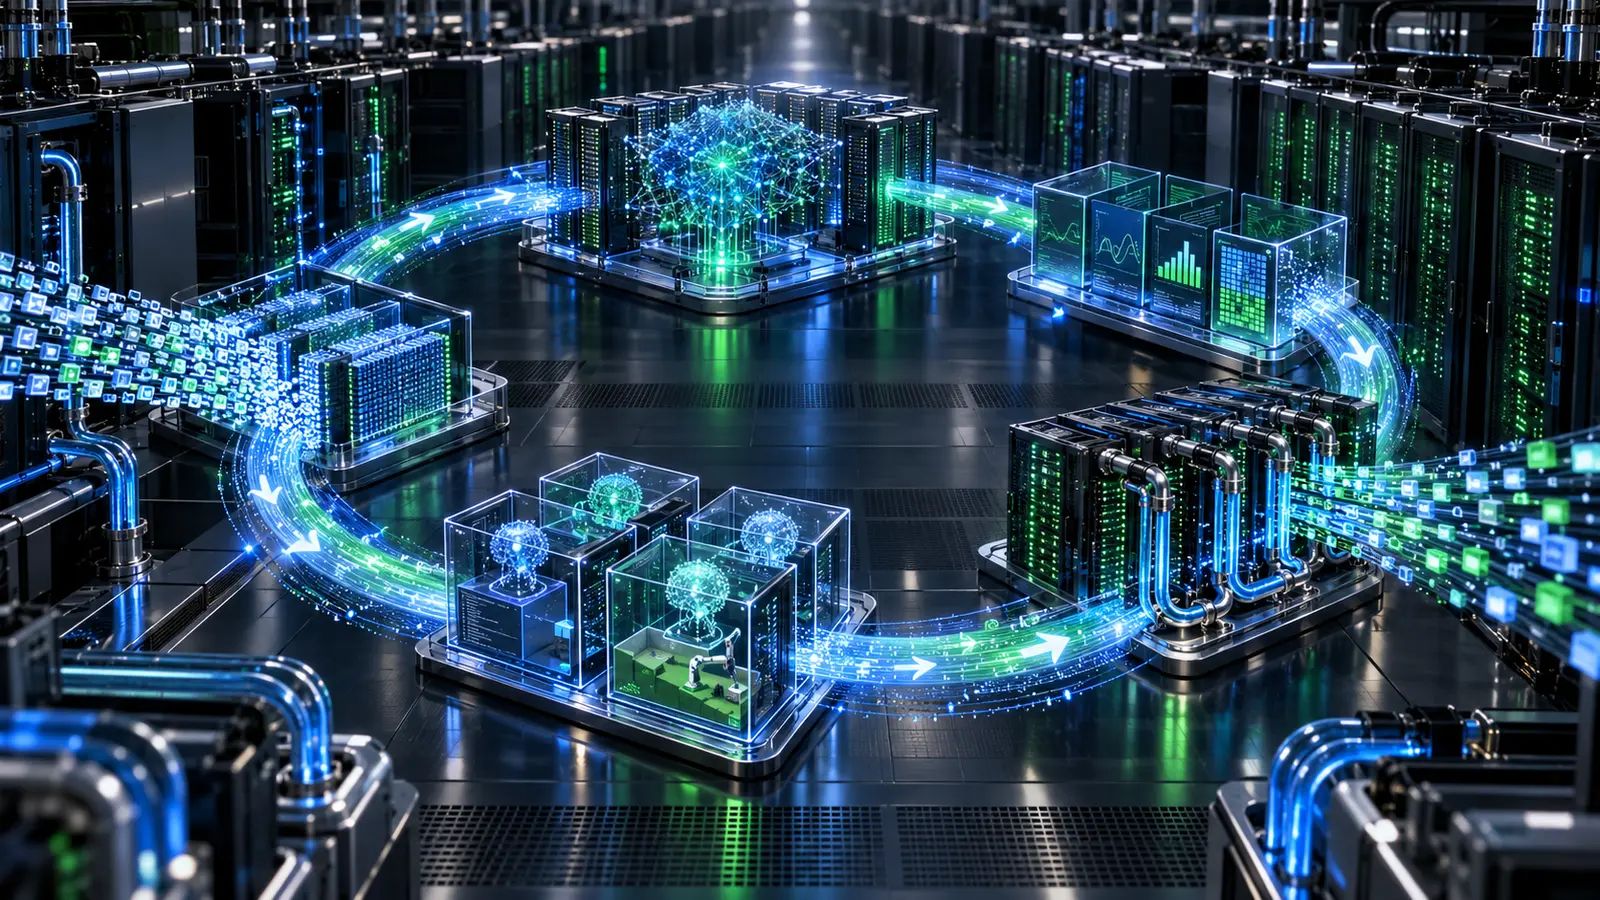
CoreWeave đã đưa NVIDIA Vera Rubin NVL72 vào production; Cognition — công ty đứng sau Devin — báo cáo mức tăng tới 4,8 lần tổng thông lượng token so với GB200 NVL72 trong thử nghiệm sớm. Cùng lúc, CoreWeave giới thiệu một vòng hạ tầng nối production trace, đánh giá, sandbox và post-training để AI Agent có thể cải thiện liên tục.
Thông tin công bố ngày 30/9/2026 đáng chú ý vì nó dịch cuộc đua chip AI sang một ngôn ngữ gần doanh nghiệp hơn: agent hoàn thành bao nhiêu công việc, môi trường thực thi khởi động nhanh đến đâu, lỗi được phát hiện sớm thế nào và chi phí sửa giảm bao nhiêu. Tuy nhiên, phần lớn số liệu đến từ NVIDIA, CoreWeave và khách hàng trên chính hạ tầng của họ; cần đọc như kết quả first-party, chưa phải benchmark độc lập cho mọi workload.
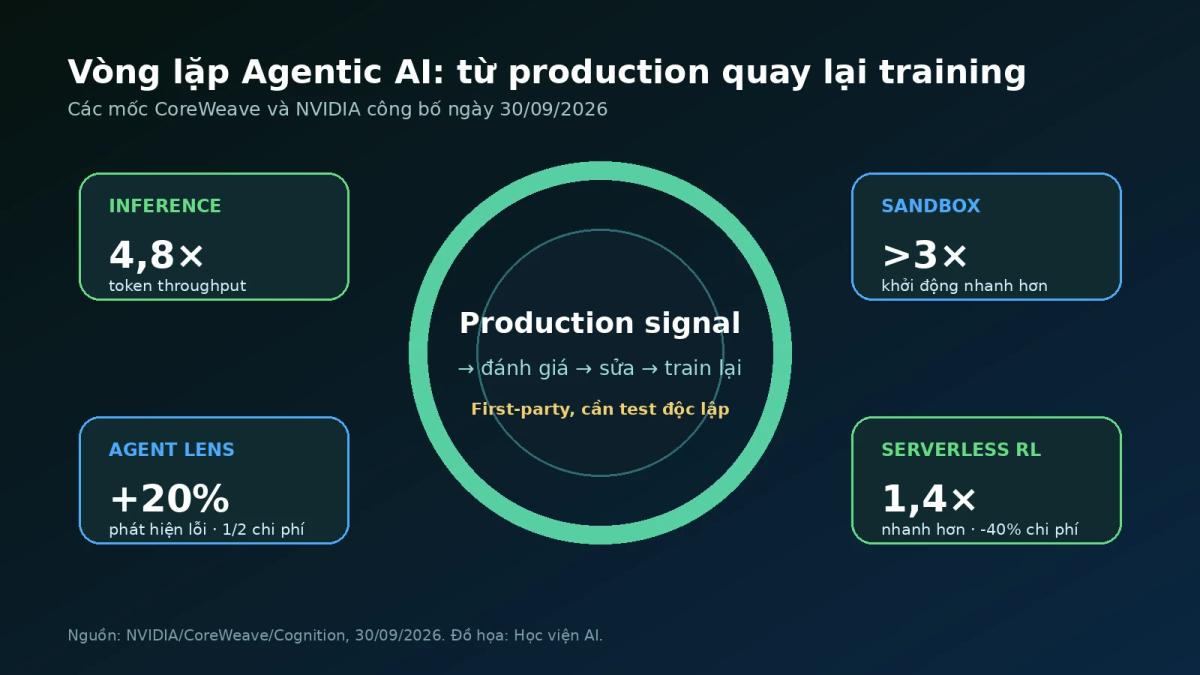
Cognition là khách hàng production đầu tiên trên Vera Rubin
Theo thông báo của NVIDIA, CoreWeave đã nhận các rack Vera Rubin NVL72 production đầu tiên và triển khai cụm cho Cognition trong vài ngày. Cognition dùng hạ tầng CoreWeave cho huấn luyện, reinforcement learning và inference của Devin; công ty nói đã mở rộng lên hàng nghìn GPU trong chín tháng.
Trong thử nghiệm sớm, Cognition lấy một tập con nhiệm vụ từ FrontierCode và cho AI Agent giải các bài toán kỹ thuật phần mềm. Kết quả do hãng công bố cho thấy Vera Rubin NVL72 đạt mức tăng tới 4,8 lần tổng thông lượng token cho workload SWE‑2 inference so với GB200 NVL72.
Từ “tới” rất quan trọng. NVIDIA không công bố trong bài số lượng tác vụ của tập con, phân phối độ dài context, độ trễ đầu-cuối hay chi phí tuyệt đối. Vì vậy, 4,8 lần không nên được diễn giải thành “mọi AI Agent nhanh hơn 4,8 lần”. Nó là tín hiệu mạnh trên một workload coding cụ thể do khách hàng và nhà cung cấp cùng đo.
Vera CPU nhắm vào nút thắt sandbox của AI Agent
Agent không chỉ cần GPU để sinh token. Với coding, RL hoặc gọi công cụ, hệ thống phải tạo hàng nghìn môi trường cô lập để chạy code, quan sát kết quả và hủy môi trường an toàn. CoreWeave cho biết một rack Vera có 128 CPU và 11.264 core, đủ cho hơn 11.000 môi trường đồng thời nếu mỗi môi trường dùng một core.
Trong thử nghiệm của CoreWeave, thời gian khởi động agent sandbox trên NVIDIA Vera nhanh hơn hơn 3 lần; trên Terminal-Bench, hiệu năng tăng 1,7 lần tính trên các nhiệm vụ đạt. Đây là lớp thường bị bỏ qua khi doanh nghiệp tính toán hạ tầng AI: model có thể phản hồi nhanh nhưng workflow vẫn chậm nếu mỗi tool call phải chờ môi trường, tải dependency hoặc khởi tạo quyền truy cập.
Thiết kế “mỗi lần gọi công cụ có một môi trường sạch” cũng liên quan trực tiếp tới an toàn. Học viện AI đã phân tích cách NVIDIA OpenShell khóa quyền AI Agent ngoài tiến trình. Sandbox nhanh chỉ tạo giá trị bền vững khi kết hợp với policy cho file, mạng, API và credential.
CoreWeave Forge nối production trace trở lại post-training
Phần chiến lược hơn của thông báo là CoreWeave Forge. Nền tảng gom Weights & Biases, năng lực post-training từ OpenPipe và notebook marimo thành một môi trường kết nối. Mục tiêu là biến hành vi agent ngoài production thành dữ liệu đánh giá, đề xuất thử nghiệm và tín hiệu cho lần cải thiện tiếp theo.
CoreWeave công bố bốn mảnh đáng chú ý:
- ARIA đã general availability, có thể phân tích run, đề xuất thí nghiệm, thay đổi code và lưu về GitHub.
- Agent Lens biến hàng chục triệu trace agent thành insight; hãng nói khả năng phát hiện lỗi tăng 20% và chi phí sửa giảm còn một nửa.
- CoreWeave Sandboxes đã general availability, tạo môi trường CPU hoặc GPU cô lập cho agent, tool call, RL và evaluation.
- Serverless RL được mô tả nhanh hơn 1,4 lần và rẻ hơn 40% so với cấu hình tự quản lý trong phép so sánh của CoreWeave.
Canva, Capital One và MasterClass được nêu là các tổ chức đầu tiên xây trên Forge. Đây là bằng chứng adoption ban đầu, nhưng bài công bố không cho biết workload, phạm vi production hay kết quả kinh doanh của từng khách hàng.
Thông lượng token chỉ là một phần của ROI
Trang sản phẩm của NVIDIA mô tả Vera Rubin NVL72 có 72 Rubin GPU, 36 Vera CPU cùng mạng NVLink 6; hãng tuyên bố chi phí trên một triệu token thấp bằng một phần mười và token trên mỗi megawatt cao tới 10 lần so với GB200 NVL72 trong cấu hình benchmark cụ thể. NVIDIA cũng lưu ý các phép đo phụ thuộc model, độ dài đầu vào/đầu ra và hiệu năng có thể thay đổi.
Doanh nghiệp không nên mua hạ tầng bằng một con số peak. Một agent production còn phụ thuộc tỷ lệ tác vụ hoàn thành, độ trễ ở p95/p99, số lần thử lại, mức sử dụng GPU, tốc độ phục hồi và nhân lực vận hành. Khi agent tạo sai hành động hoặc cần con người sửa, token rẻ hơn không tự động biến thành outcome rẻ hơn.
Đây là lý do bài Huawei Agentic Infra phục vụ hơn 3.500 khách hàng cũng nhấn mạnh bộ nhớ, phục hồi lỗi và quản trị agent. Hạ tầng AI đang được đánh giá như một hệ thống hoàn chỉnh thay vì chỉ là số GPU.
Nhận định của Học viện AI: lợi thế mới nằm ở vòng học, không chỉ ở chip
Phần dưới đây là nhận định của Học viện AI. Tín hiệu quan trọng nhất không phải Vera Rubin nhanh hơn một thế hệ GPU trước. Lợi thế dài hạn có thể nằm ở tốc độ khép vòng: production tạo trace → trace thành bộ đánh giá → đánh giá tìm lỗi → lỗi tạo dữ liệu post-training → phiên bản mới quay lại production.
Nếu vòng này mất nhiều tuần và dữ liệu nằm rải rác giữa công cụ, agent khó cải thiện ổn định. Nếu vòng được khép trong vài ngày với sandbox tái lập, version rõ và tiêu chí outcome cố định, doanh nghiệp có thể biến kinh nghiệm vận hành thành lợi thế riêng — dù cùng dùng một model nền tảng như đối thủ.
Cách nhìn này bổ sung cho OpenAI DevDay 2026: sản phẩm agent đang chuyển từ một lần chat sang trách nhiệm kéo dài. Khi trách nhiệm dài hơn, hạ tầng evaluation và recovery trở thành phần bắt buộc, không phải tính năng phụ.
Năm số doanh nghiệp cần yêu cầu trong pilot
- Task success rate trên bộ việc thật, không chỉ benchmark công khai.
- Chi phí mỗi outcome đạt chuẩn, gồm token, sandbox, lưu trữ và review.
- Độ trễ p95 cho toàn workflow, không chỉ tốc độ sinh token.
- Tỷ lệ lỗi tái hiện được và thời gian từ phát hiện tới bản sửa được kiểm chứng.
- Mức sử dụng hạ tầng trong giờ thấp điểm và cao điểm để tránh mua công suất nằm chờ.
Với nhiều doanh nghiệp Việt Nam, bước đúng chưa phải thuê một cụm Vera Rubin. Hãy chạy pilot trên cloud với workload hẹp, lưu trace và tạo bộ test nội bộ. Sau 30–45 ngày, bạn mới có dữ liệu để biết nút thắt nằm ở model, retrieval, tool, sandbox hay quy trình con người.
Nếu cần xây quy trình AI Agent có KPI, quyền và checkpoint rõ ràng trước khi đầu tư hạ tầng, xem các chương trình AI thực chiến của Học viện AI.
Nguồn và giới hạn
- NVIDIA: “From Training to Production, NVIDIA and CoreWeave Close the Loop on Agentic AI”, 30/9/2026.
- NVIDIA Vera Rubin NVL72 — thông số và chú thích benchmark, truy cập 1/10/2026.
Các mức 4,8 lần, hơn 3 lần, 20%, một nửa chi phí, 1,4 lần và 40% là kết quả do NVIDIA/CoreWeave/Cognition công bố. Nguồn không cung cấp đầy đủ cỡ mẫu và cấu hình cho mọi phép đo; bài không ngoại suy các kết quả này cho mọi agent hoặc hạ tầng.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI