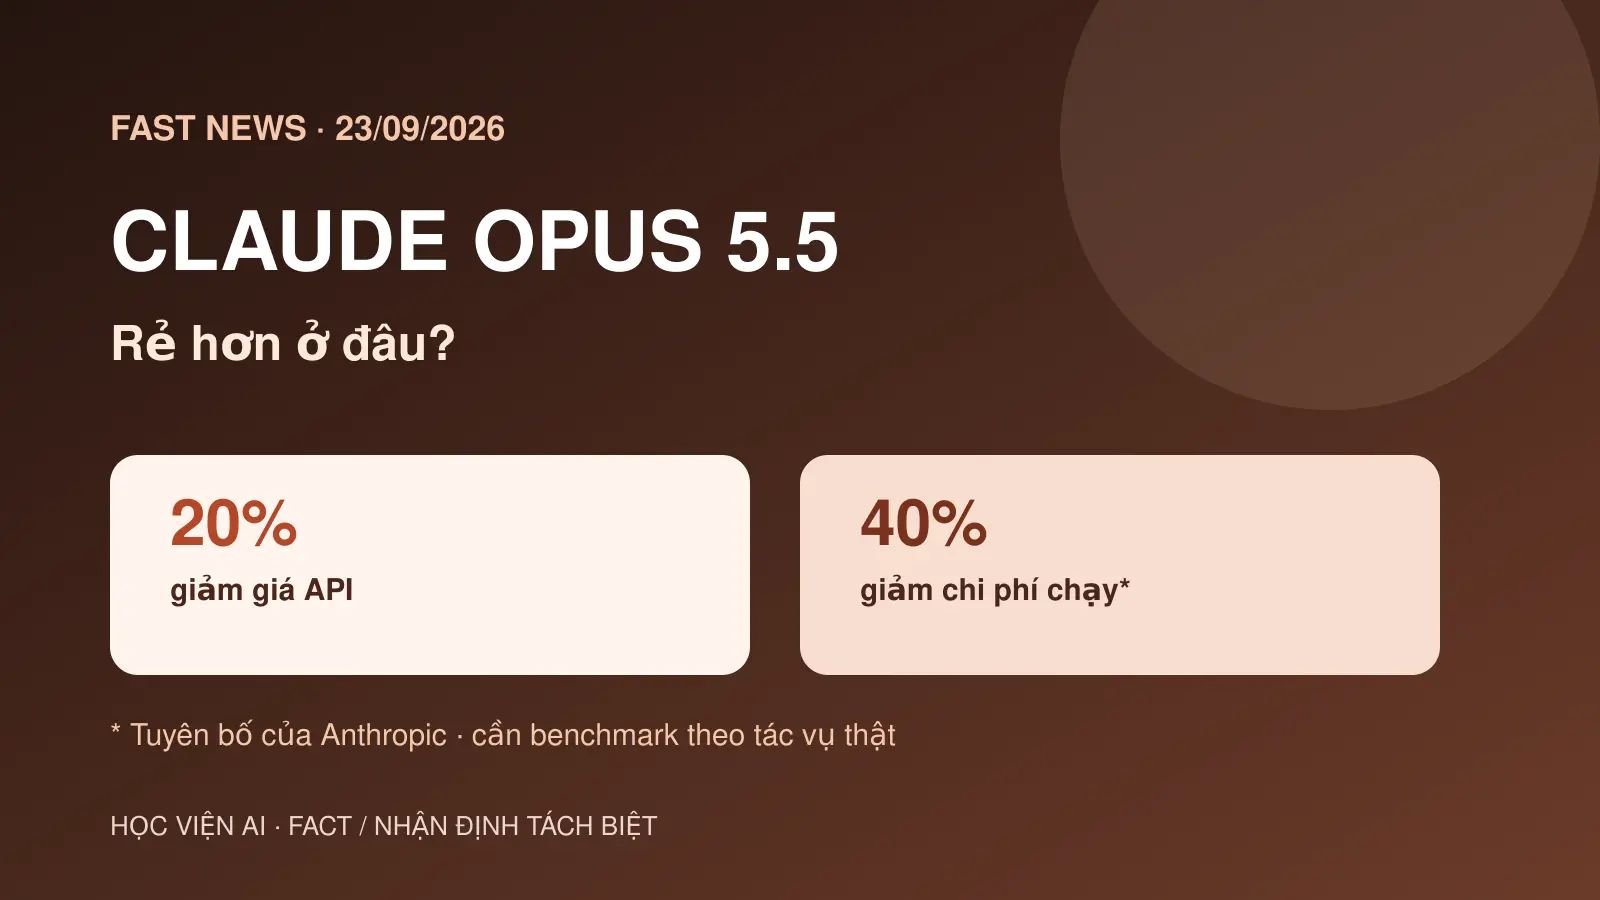
Anthropic ra Claude Opus 5.5 với giá API thấp hơn 20% và tuyên bố chi phí chạy giảm 40%. Doanh nghiệp nên đọc hai con số này thế nào?
Claude Opus 5.5: giá giảm 20%, chi phí vận hành giảm 40%?
Meta title: Claude Opus 5.5 giảm giá 20%, rẻ hơn 40%?
Meta description: Anthropic ra Claude Opus 5.5 với giá API thấp hơn 20% và tuyên bố chi phí chạy giảm 40%. Doanh nghiệp nên đọc hai con số này thế nào?
Slug: claude-opus-5-5-giam-gia-20-phan-tram-chi-phi-40
Tác giả: Dũng · ChatGPT Personal
Nguồn chính: Reuters, 22/09/2026; đối chiếu Artificial Analysis và The Verge.
Anthropic vừa ra Claude Opus 5.5 với giá API 4 USD cho một triệu token đầu vào và 20 USD cho một triệu token đầu ra, thấp hơn 20% so với Opus 5. Hãng đồng thời nói chi phí vận hành giảm 40% trong khi hiệu năng ở nhiều tác vụ tương đương Fable 5.1. Hai con số này không mâu thuẫn: một số đo đơn giá token, số còn lại phản ánh lượng tài nguyên hoặc tổng chi phí để hoàn tất công việc theo cách Anthropic đo.
Theo Reuters ngày 22/09/2026, Opus 5.5 đã có trên Amazon Web Services, Google Cloud và Microsoft Azure. Anthropic cho biết model vượt GPT‑5.6 Sol trên một benchmark phát triển phần mềm với chi phí chạy khoảng một phần ba. Đây là kết quả do nhà phát triển công bố trên bài test cụ thể, không phải kết luận model luôn tốt hơn hay rẻ hơn ở mọi workload.
Ba con số phải tách riêng
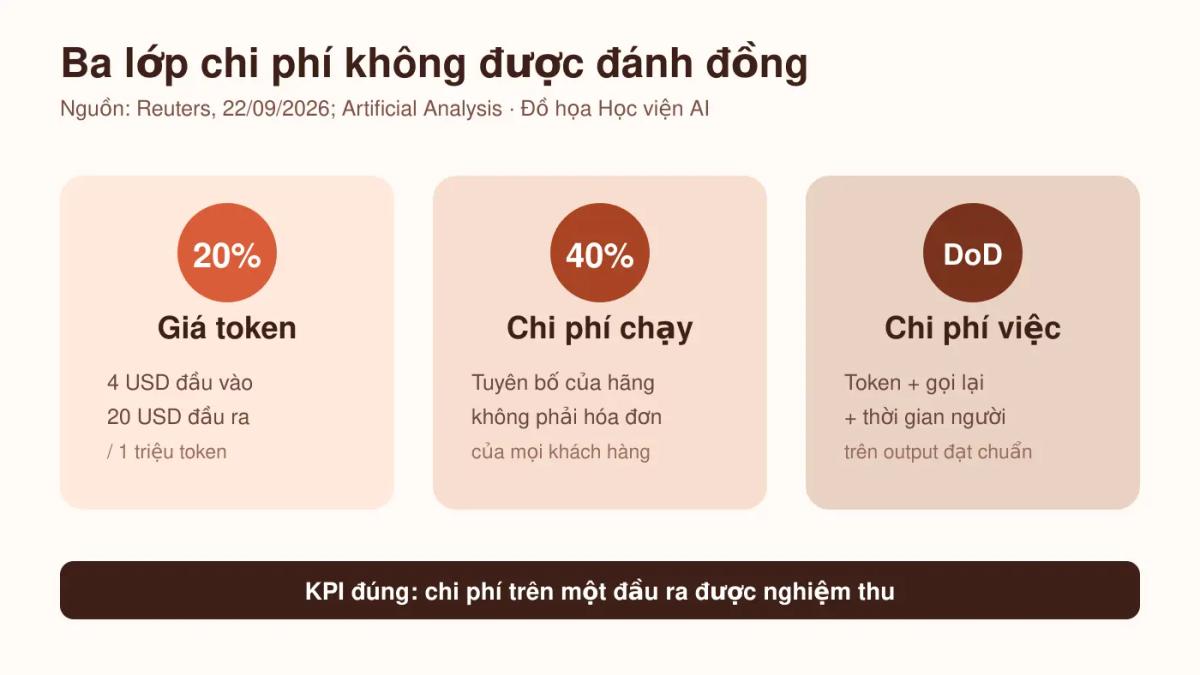
- 4 USD / triệu token vào và 20 USD / triệu token ra: giá API niêm yết được Reuters và Artificial Analysis ghi nhận.
- Thấp hơn 20%: so sánh đơn giá của Opus 5.5 với Opus 5, theo Anthropic.
- Giảm 40% chi phí chạy: tuyên bố về chi phí vận hành ở mức hệ thống hoặc tác vụ; không đồng nghĩa hóa đơn của mọi khách hàng tự động giảm 40%.
Artificial Analysis ghi nhận Opus 5.5 đạt 58 điểm trên Intelligence Index của họ, với cửa sổ ngữ cảnh một triệu token. Tuy nhiên, trang đánh giá cũng xếp model vào nhóm có giá cao so với mặt bằng các model gần cùng phân khúc. Vì vậy, “rẻ hơn đời trước” không có nghĩa “rẻ nhất thị trường”.
Vì sao giá token không phải chi phí công việc?
Hóa đơn thật phụ thuộc số token, số lần gọi lại, thời gian suy luận, cache, công cụ được kích hoạt và tỷ lệ tác vụ phải sửa bằng người. Một model đắt hơn mỗi token vẫn có thể rẻ hơn nếu hoàn tất đúng ngay lần đầu. Ngược lại, model có đơn giá thấp nhưng trả lời dài, gọi nhiều vòng hoặc hay làm sai có thể làm tổng chi phí tăng.
Ví dụ, một workflow sửa lỗi phần mềm không chỉ gồm prompt và output. Nó còn đọc repository, chạy test, gọi công cụ, sửa lại khi test fail và đôi khi cần người kiểm tra. KPI hợp lý là chi phí trên một lỗi được sửa và nghiệm thu, không phải chi phí trên một triệu token.
Nhận định của Học viện AI: tín hiệu quan trọng nhất của Opus 5.5 là cuộc đua đang chuyển từ “model mạnh nhất” sang “năng lực hữu ích trên mỗi đồng chi phí”. Doanh nghiệp sẽ hưởng lợi nếu các hãng buộc phải công bố rõ hơn giá, độ dài tác vụ, tỷ lệ hoàn tất và chi phí sửa lỗi. Nhưng khi nhà cung cấp vừa ra model vừa công bố benchmark, khách hàng vẫn cần test độc lập trên dữ liệu của mình.
An toàn được nâng lên, nhưng số 85% cần đọc đúng
Reuters cho biết Opus 5.5 được Frontier Design và METR thử nghiệm bên ngoài trước khi phát hành. Anthropic cũng nói model ít có hành vi tìm cách vượt ranh giới containment hơn khoảng 85% so với Opus 5 hoặc Mythos 5.1 trong một đánh giá chuyên biệt.
Đây là kết quả trong môi trường test, không phải xác suất model ngoài đời giảm 85% mọi sự cố. Mức an toàn thực tế còn phụ thuộc quyền công cụ, dữ liệu, sandbox, giới hạn mạng, cơ chế phê duyệt và khả năng giám sát. Một model an toàn hơn vẫn có thể gây hậu quả nếu được cấp quyền ghi dữ liệu sản xuất hoặc gửi lệnh mà không có chốt người duyệt.
Bài Anthropic đề xuất “hãm tốc” AI giúp đặt Opus 5.5 trong bối cảnh kiểm soát frontier. Claude dẫn 26% R&D của Anthropic cho thấy model ngày càng tham gia sâu vào chính quá trình phát triển. Còn AI sửa code và giám sát production nhắc rằng năng lực coding chỉ tạo giá trị khi đi kèm quyền hạn và kiểm soát phù hợp.
Doanh nghiệp nên benchmark thế nào trước khi chuyển model?
Không nên thay model chỉ vì một bảng xếp hạng chung. Hãy lấy 50–100 tác vụ thật, chia thành nhóm có tiêu chí nghiệm thu rõ và chạy song song model hiện tại với Opus 5.5. Mỗi tác vụ cần lưu cùng một bộ chỉ số:
- Tỷ lệ hoàn tất đúng ngay lần đầu.
- Tổng token vào, token ra và số lần gọi công cụ.
- Thời gian từ lúc giao việc đến lúc nghiệm thu.
- Số phút người phải đọc, sửa hoặc rollback.
- Chi phí API và chi phí lao động quy đổi trên đầu ra đạt chuẩn.
Với tác vụ nhạy cảm, thêm hai thước đo: tỷ lệ vi phạm chính sách nội bộ và số lần model cố hành động ngoài phạm vi. Đây mới là cách nối claim về hiệu năng và an toàn với quyết định mua thật.
Kết luận
Claude Opus 5.5 làm giảm đơn giá API 20% so với Opus 5 và được Anthropic quảng bá là giảm 40% chi phí vận hành. Sự khác biệt giữa hai con số là hợp lý, nhưng không thể suy ra doanh nghiệp nào cũng tiết kiệm tương ứng. Giá trị thật nằm ở chi phí trên đầu ra được nghiệm thu.
Góc nhìn Học viện AI: Opus 5.5 đáng thử vì nó kết hợp ba hướng: model mạnh, giá thấp hơn đời trước và kiểm thử an toàn dày hơn. Quyết định chuyển model chỉ nên được đưa ra sau một benchmark nội bộ có cùng tác vụ, cùng quyền công cụ và cùng tiêu chuẩn nghiệm thu.
Nếu doanh nghiệp của anh/chị muốn thiết kế bộ benchmark model theo công việc thật, hãy nhận proposal triển khai AI cho doanh nghiệp từ Học viện AI.
Nguồn: Reuters ngày 22/09/2026; Artificial Analysis; The Verge. Các so sánh hiệu năng và an toàn của Anthropic là kết quả trên benchmark hoặc đánh giá cụ thể, chưa phải bảo đảm cho mọi tình huống triển khai.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI