OpenAI và Google cùng ủng hộ tín hiệu robots.txt dùng chung cho huấn luyện AI. Đây chưa phải nút chặn phổ quát; website Việt cần tách quyền training, tìm kiếm và truy cập do người dùng yêu cầu.
Tóm tắt: Ngày 30/10/2026, OpenAI và Google cùng công bố kế hoạch hỗ trợ một tín hiệu chung trong robots.txt để website thể hiện lựa chọn về việc dùng nội dung cho huấn luyện AI. Đây là bước tiến đáng chú ý, nhưng chưa phải “nút chặn mọi AI”: đặc tả vẫn là Internet-Draft, các nhà cung cấp có lịch triển khai khác nhau và quyền huấn luyện phải được quản riêng với quyền xuất hiện trong tìm kiếm AI.
Nếu đang vận hành website doanh nghiệp, trường học, báo điện tử hoặc kho kiến thức, bạn chưa cần vội sao chép một dòng cấu hình mới rồi coi như xong. Việc nên làm ngay là rà lại mục tiêu: trang nào cần được tìm thấy, nội dung nào không muốn dùng cho huấn luyện và bot nào đang truy cập thực tế. Bài này tách rõ phần đã được xác nhận, phần chưa có hiệu lực rộng và một quy trình kiểm tra an toàn cho website Việt Nam.
Có gì mới trong robots.txt cho AI?
OpenAI công bố ngày 30/10/2026 rằng hãng sẽ tôn trọng một tín hiệu chung trong robots.txt để website truyền đạt lựa chọn về huấn luyện mô hình nền tảng. Mục tiêu là giảm việc chủ website phải duy trì quy tắc riêng cho từng nhà cung cấp. OpenAI nói sẽ triển khai trong “những tháng tới” và sẽ công bố chi tiết khi sẵn sàng; các kiểm soát crawler hiện có vẫn tiếp tục áp dụng.
Cùng ngày, Google Search Central cho biết có kế hoạch hỗ trợ tín hiệu chung dựa trên công việc của nhóm AIPREF tại IETF. Google dự kiến hỗ trợ cùng các nhà cung cấp khác trong năm 2027. Quy tắc riêng Google-Extended, đã có từ năm 2023, vẫn hoạt động song song.
Tín hiệu đang được mô tả trong Internet-Draft draft-kelley-aipref-training-preference-signal-00. Bản nháp đề xuất một “policy token” tên __usage_ai-training. Điểm cần nhấn mạnh: Internet-Draft không phải tiêu chuẩn IETF đã được phê chuẩn, không có vị thế tiêu chuẩn chính thức và có thể thay đổi hoặc hết hạn.
Kết luận thực hành: Đây là tín hiệu đáng theo dõi và chuẩn bị, chưa phải lời bảo đảm rằng mọi hệ thống AI đã đọc hoặc sẽ tuân thủ ngay hôm nay.
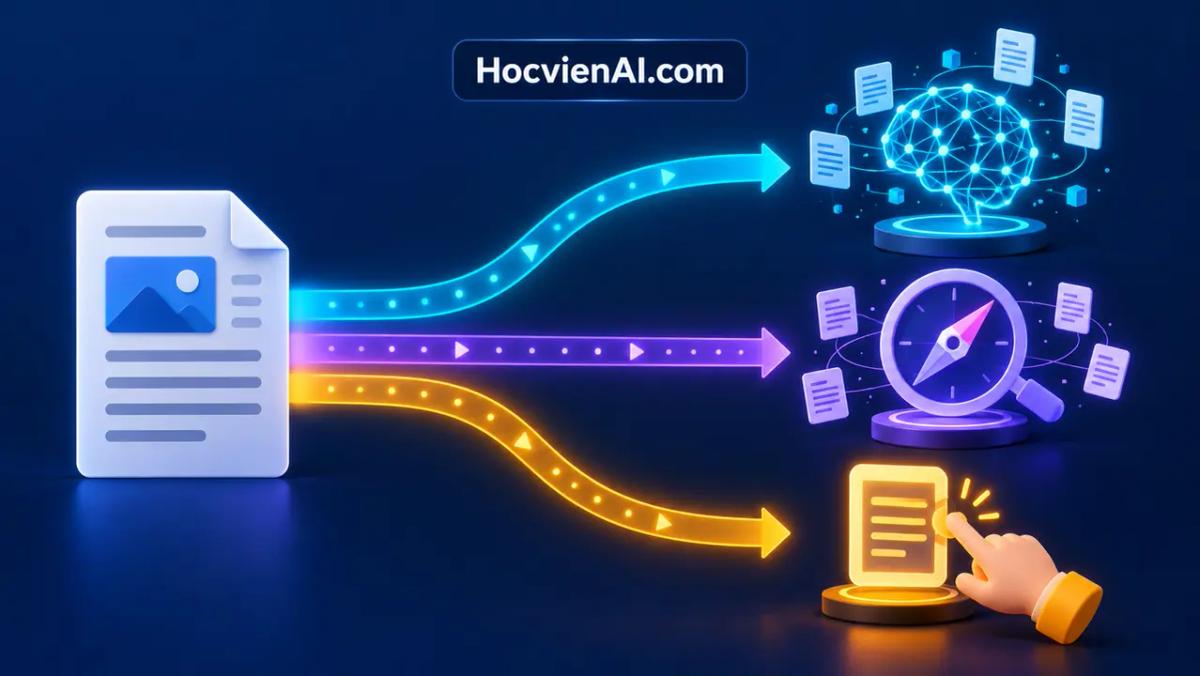
Ba quyền khác nhau: huấn luyện, tìm kiếm và lượt truy cập do người dùng yêu cầu
Sai lầm dễ gặp nhất là dùng một từ “AI crawler” cho mọi mục đích. Trên thực tế, ít nhất ba luồng cần được quyết định riêng.
| Mục đích | Ví dụ của OpenAI | Điều website cần hiểu |
|---|---|---|
| Huấn luyện mô hình nền tảng | GPTBot | Chặn bot này thể hiện rằng nội dung không nên được dùng để huấn luyện mô hình nền tảng của OpenAI. |
| Xuất hiện trong tìm kiếm AI | OAI-SearchBot | Nếu chặn, trang có thể không xuất hiện trong câu trả lời tìm kiếm ChatGPT, dù vẫn có thể hiện như liên kết điều hướng. |
| Người dùng yêu cầu mở trang | ChatGPT-User | Đây không phải crawler tự động. Vì hành động do người dùng khởi tạo, quy tắc robots.txt có thể không áp dụng theo cách tương tự. |
Tài liệu crawler của OpenAI xác nhận các cài đặt này độc lập. Một website có thể cho phép OAI-SearchBot để được tìm thấy trong ChatGPT Search, đồng thời chặn GPTBot để thể hiện lựa chọn không dùng nội dung cho huấn luyện. OpenAI cũng lưu ý thay đổi với tìm kiếm có thể cần khoảng 24 giờ để hệ thống điều chỉnh.
Với Google, thông báo mới cũng giữ nguyên logic “quy tắc chung cộng với ngoại lệ cụ thể”. Nếu website dùng policy token chung để từ chối huấn luyện nhưng không ghi rõ Google-Extended, Google dự kiến hiểu tín hiệu đó như việc chặn Google-Extended. Nếu chủ website ghi cụ thể quy tắc riêng, quy tắc cụ thể sẽ cho phép tinh chỉnh lựa chọn theo nhà cung cấp.
Một dòng robots.txt có đủ chặn AI học dữ liệu website?
Chưa đủ. Có bốn lý do.
- Đây là tín hiệu tự nguyện. Cơ chế chỉ có giá trị khi nhà cung cấp tham gia và thực thi đúng cam kết.
- Đặc tả còn là bản nháp. Tên token, cách xử lý xung đột và chi tiết triển khai có thể tiếp tục được chỉnh sửa.
- Lịch hỗ trợ chưa đồng nhất. OpenAI nói “những tháng tới”, còn Google nhắm tới năm 2027. Không nên coi cú pháp đề xuất là đã vận hành đồng loạt ngày 2/11/2026.
- robots.txt không phải kiểm soát truy cập. Tệp này truyền đạt lựa chọn cho bot tuân thủ. Nó không thay thế xác thực, phân quyền, tường lửa, giới hạn API hoặc biện pháp bảo vệ dữ liệu nhạy cảm.
Nếu website có nội dung riêng tư, tài liệu nội bộ, dữ liệu học viên hoặc thông tin khách hàng, giải pháp đúng là đặt chúng sau lớp đăng nhập và kiểm soát quyền. Đừng dựa vào robots.txt như một “ổ khóa”.
Cú pháp dự thảo trông như thế nào?
Bản Internet-Draft hiện nêu ví dụ sau để thể hiện lựa chọn không dùng mọi đường dẫn cho huấn luyện AI, ngoại trừ thư mục /press-kit/:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Điều này không có nghĩa bạn nên dán ngay vào website production. Hãy coi đây là ví dụ giúp đội kỹ thuật hiểu hướng thiết kế. Trước khi áp dụng, cần kiểm tra phiên bản đặc tả mới nhất và tài liệu triển khai chính thức của từng nhà cung cấp. Bản nháp cũng nói policy token này không phải crawler thật và không tự điều khiển việc crawl; nó là một nhóm chính sách dùng chung trong cú pháp quen thuộc của robots.txt.
Website Việt Nam nên làm gì ngay bây giờ?
1. Lập bảng mục tiêu theo loại nội dung
Đừng bắt đầu bằng tên bot. Hãy bắt đầu bằng giá trị của từng khu vực website:
- Trang sản phẩm, dịch vụ, bài kiến thức: thường cần được tìm thấy để có traffic và khách hàng.
- Press kit hoặc tài liệu được phép chia sẻ: có thể mở rộng hơn nếu mục tiêu là lan tỏa.
- Nội dung trả phí, khóa học, tài liệu độc quyền: cần chính sách riêng và biện pháp kiểm soát truy cập thực sự.
- Dữ liệu cá nhân, tài liệu nội bộ: không nên công khai để rồi mới cố chặn bot.
2. Đọc robots.txt hiện tại trước khi sửa
Mở https://tenmiencuaban/robots.txt, lưu lại bản hiện tại và kiểm tra các nhóm User-agent, Disallow, Allow. Với website dùng CMS hoặc CDN, một plugin SEO, firewall hoặc nền tảng hosting có thể đang sinh tệp này. Sửa ở sai lớp dễ khiến thay đổi bị ghi đè.
3. Tách quyết định “được tìm thấy” khỏi “được dùng để huấn luyện”
Với OpenAI, một SME có thể cho phép OAI-SearchBot để bài blog có cơ hội xuất hiện trong ChatGPT Search, đồng thời chặn GPTBot để thể hiện lựa chọn không dùng nội dung cho huấn luyện mô hình nền tảng. Không nên suy rộng cách tách này sang mọi nhà cung cấp: Google nói website cho phép rõ Google-Extended mới đủ điều kiện xuất hiện và nhận lượt nhấp qua grounding trong Gemini Apps. Vì vậy, hãy ghi rõ mục tiêu theo từng hệ sinh thái rồi đối chiếu tài liệu chính thức trước khi sửa.
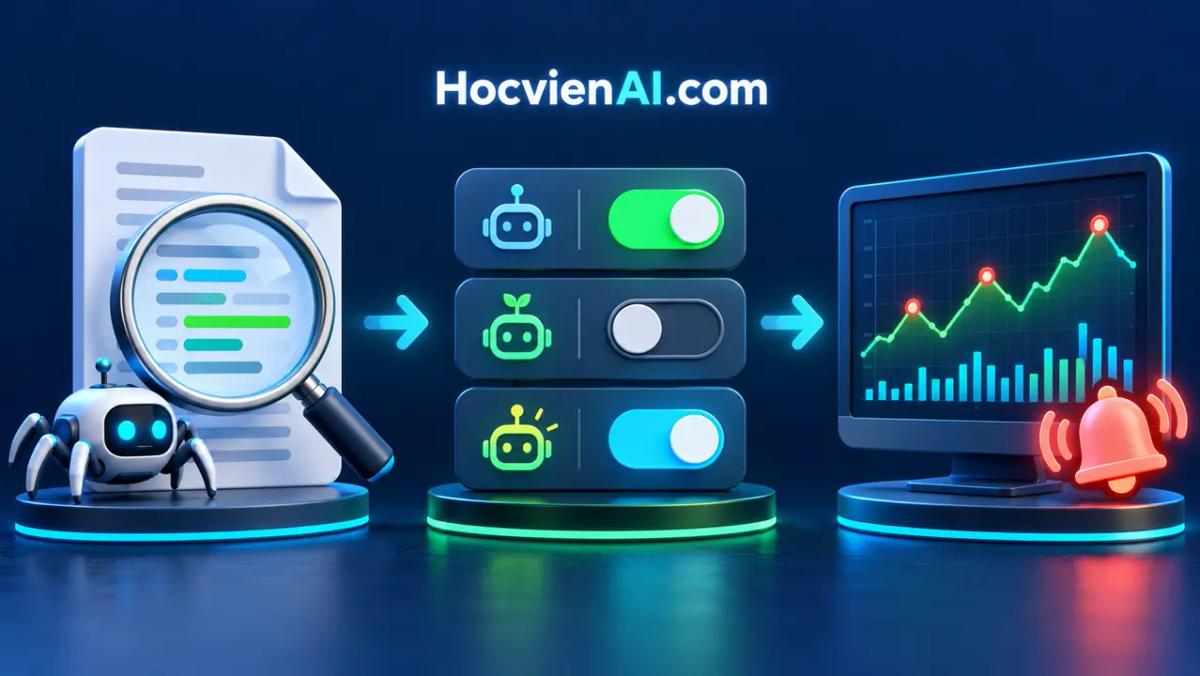
4. Thử trên phạm vi nhỏ và giám sát log
Chọn một thư mục ít rủi ro, thay đổi một chính sách, rồi theo dõi access log và khả năng xuất hiện trong tìm kiếm. Đừng thay toàn site trong một lần nếu website phụ thuộc traffic tự nhiên. Với OpenAI Search, hãy tính cả độ trễ điều chỉnh khoảng 24 giờ mà tài liệu hãng đã nêu.
5. Ghi người duyệt và ngày kiểm lại
Chính sách AI crawler đang thay đổi nhanh. Mỗi thay đổi nên có người chịu trách nhiệm, lý do, ngày áp dụng và lịch kiểm lại sau 30–90 ngày. Đây là cách tránh một dòng cấu hình cũ âm thầm làm mất traffic hoặc không còn đúng với mục tiêu kinh doanh.
Bảng kiểm 10 phút cho marketing và chủ SME
- [ ] Xác định trang nào cần được tìm thấy trong tìm kiếm AI.
- [ ] Xác định nội dung nào không muốn dùng cho huấn luyện.
- [ ] Kiểm tra
robots.txthiện tại và nơi quản lý tệp. - [ ] Đối chiếu bot theo tài liệu chính thức, không theo danh sách truyền tay.
- [ ] Chưa đưa dữ liệu nhạy cảm lên web công khai.
- [ ] Lưu bản cấu hình trước khi sửa và chuẩn bị cách hoàn tác.
- [ ] Theo dõi access log, Search Console và traffic sau thay đổi.
- [ ] Đặt ngày kiểm lại khi đặc tả IETF hoặc nhà cung cấp cập nhật.
Nếu cần rà cả trải nghiệm chuyển đổi sau khi xử lý crawler, bạn có thể dùng miễn phí công cụ Chẩn đoán Website của Học viện AI. Công cụ này chấm các điểm rò phổ biến; để hiểu trước các tiêu chí, xem thêm bài Website của bạn đang rò khách ở đâu?
Giới hạn cần nhớ
Tín hiệu chung mới giúp giảm công việc vận hành nếu được nhiều nhà cung cấp hỗ trợ. Nó không giải quyết mọi tranh luận pháp lý về quyền tác giả, không ngăn bot không tuân thủ và không thay thế hợp đồng hoặc biện pháp kỹ thuật. Tại thời điểm 2/11/2026, doanh nghiệp nên chuẩn bị chính sách và thử nghiệm có kiểm soát, nhưng chưa nên tuyên bố “đã chặn mọi AI học dữ liệu”.
Nhận định của Học viện AI: Lợi ích lớn nhất của đề xuất này không nằm ở một dòng cú pháp. Nó buộc đội marketing, nội dung và kỹ thuật tách rõ ba mục tiêu từng bị gộp chung: được khám phá, được sử dụng để huấn luyện và được truy cập theo yêu cầu người dùng. Khi ba mục tiêu rõ, website mới có thể chọn chính sách mà không vô tình đánh đổi traffic hoặc quyền kiểm soát.
Nguồn xác minh
- OpenAI — Making it easier for websites to express AI training preferences, 30/10/2026.
- Google Search Central — Supporting a shared AI training control for websites, 30/10/2026.
- IETF Datatracker — draft-kelley-aipref-training-preference-signal-00, cập nhật 30/10/2026.
- OpenAI Developers — Overview of OpenAI Crawlers, truy cập 2/11/2026.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI