Prime Intellect công bố hạ tầng suy luận cho workload AI Agent dài hạn, cùng số đo gần 1.000 tỷ token mỗi ngày và 101 token/giây/người dùng.
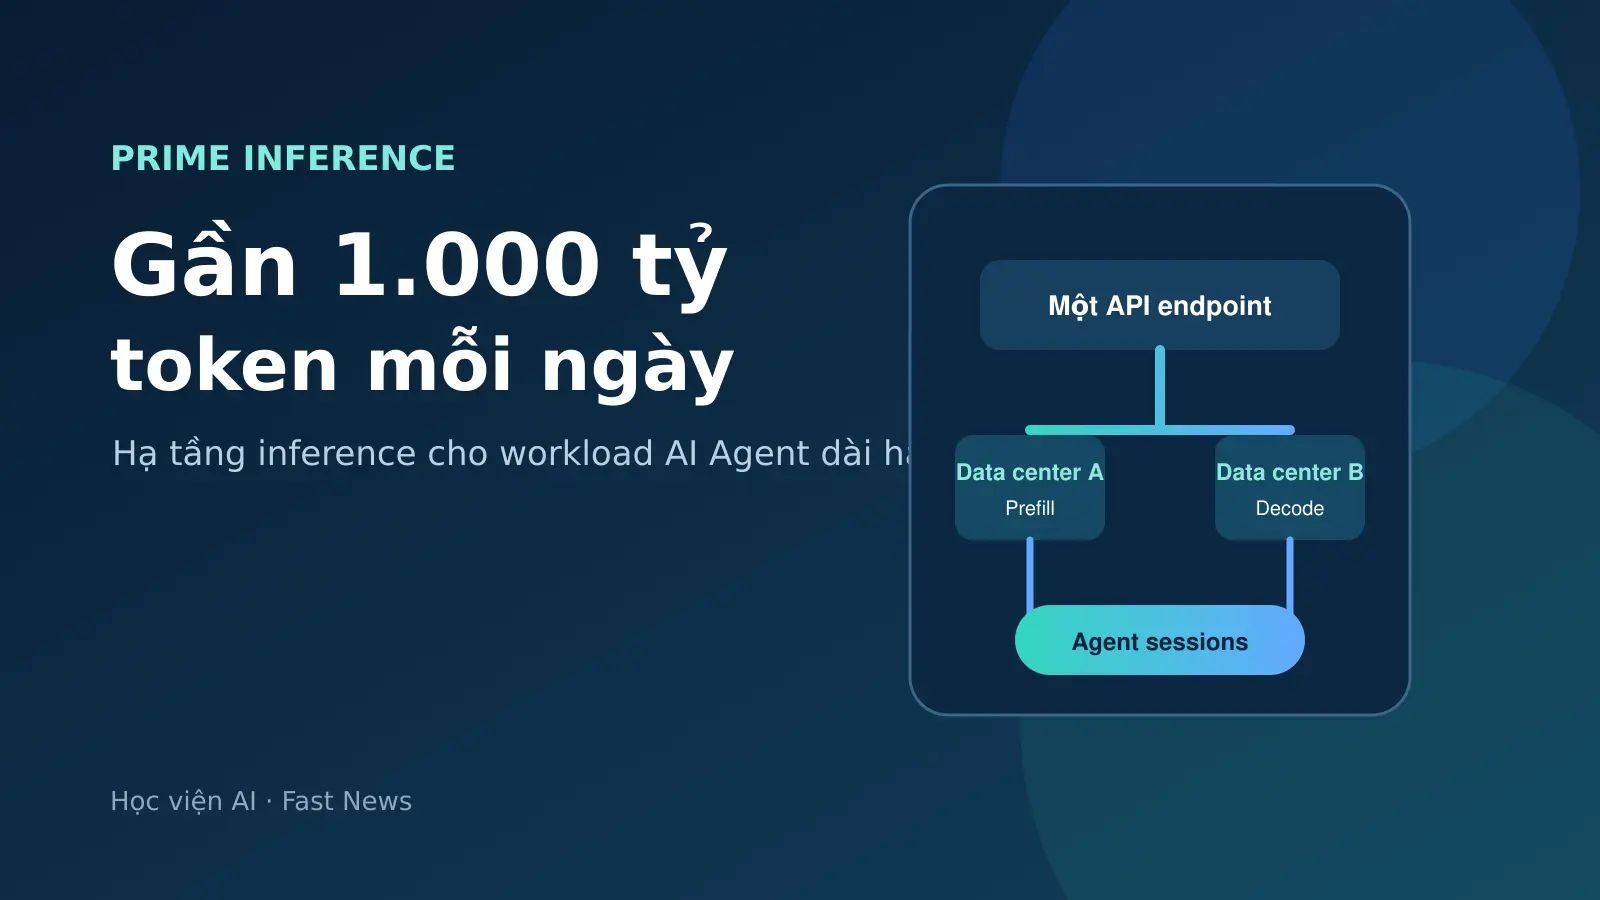
Prime Intellect ngày 2/10/2026 công bố Prime Inference, một dịch vụ suy luận cho mô hình nguồn mở mà công ty nói đang phục vụ gần 1.000 tỷ token mỗi ngày. Điểm đáng chú ý không chỉ nằm ở quy mô do nhà cung cấp tự báo cáo, mà ở cách hệ thống được thiết kế cho AI Agent: prompt dài, lịch sử được tái sử dụng và nhiều phiên đồng thời.
Đây là tín hiệu đáng theo dõi với đội ngũ đang xây agent vận hành thật. Khi một lượt làm việc có thể kéo theo hàng trăm nghìn token ngữ cảnh, tốc độ sinh token đơn thuần không còn đủ để đánh giá chất lượng hạ tầng.
Dữ kiện đã xác minh từ Prime Intellect
Theo thông báo chính thức của Prime Intellect, Prime Inference cung cấp hai lựa chọn: serverless endpoint và năng lực tính toán đặt trước. Cả hai dùng API tương thích OpenAI và phục vụ các mô hình nguồn mở ở nhiều trung tâm dữ liệu.
| Chỉ số công bố | Ý nghĩa cần đọc đúng |
|---|---|
| Gần 1.000 tỷ token/ngày | Khối lượng xử lý cho workload nội bộ của Prime Intellect; chưa phải số đo kiểm toán độc lập. |
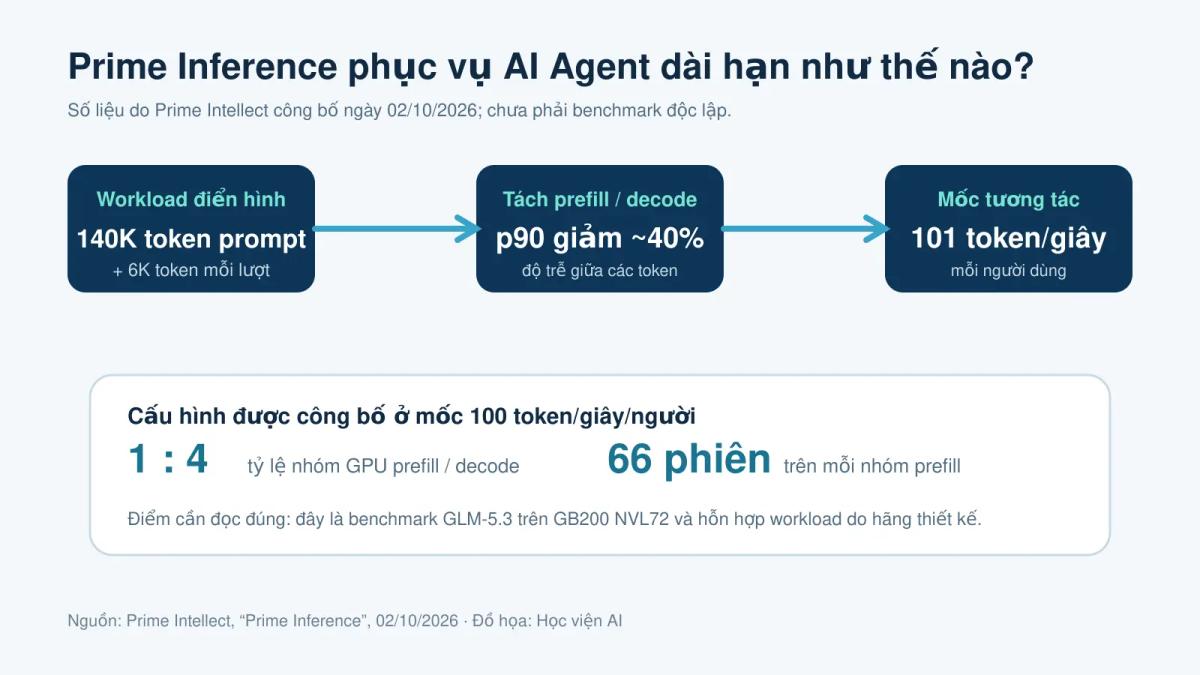
| Prompt điển hình 140.000 token | Mỗi lượt agent bổ sung khoảng 6.000 token và tái sử dụng phần lớn lịch sử trước đó. |
| p90 inter-token latency giảm gần 40% | Kết quả thử nghiệm của hãng khi tách phần prefill và decode. |
| 101 token/giây/người dùng | Kết quả trên workload GLM-5.3, cấu hình GB200 NVL72 và tỷ lệ nhóm prefill/decode 1:4. |
Vì sao workload AI Agent khác chatbot thông thường?
Một chatbot hỏi–đáp ngắn thường nhận prompt vừa phải rồi sinh một câu trả lời. AI Agent dài hạn thì khác: nó giữ lịch sử, gọi công cụ, đọc kết quả và lặp lại nhiều vòng. Phần ngữ cảnh cũ lớn hơn rất nhiều so với lượng token mới thêm vào ở mỗi lượt.
Prime Intellect cho biết workload điển hình của họ có prompt khoảng 140.000 token nhưng chỉ thêm khoảng 6.000 token mỗi lượt. Trong trường hợp này, lợi thế không chỉ đến từ GPU nhanh mà còn từ khả năng giữ và định tuyến đúng KV cache — dữ liệu trung gian giúp mô hình không phải tính lại toàn bộ lịch sử.
Công ty tách hai pha xử lý: prefill đọc và mã hóa prompt; decode sinh token đầu ra. Một bộ định tuyến nhận biết KV cache sẽ đưa phiên làm việc về đúng nơi đang giữ trạng thái. Theo tài liệu Prime Inference, cùng một endpoint có thể trỏ tới mô hình do Prime lưu trữ hoặc mô hình đi qua gateway; doanh nghiệp vẫn phải kiểm tra nơi hạ tầng thực sự chạy và chính sách dữ liệu tương ứng.
Con số 101 token/giây/người dùng nói lên điều gì?
Trong bài công bố, Prime dùng mục tiêu tương tác 100 token/giây/người dùng. Ở tỷ lệ một nhóm GPU prefill cho bốn nhóm decode, hãng báo cáo phục vụ 66 phiên trên mỗi nhóm prefill, đạt 101 token/giây/người dùng và 100 token đầu ra/giây/GPU.
Không nên chuyển thẳng con số này thành cam kết hiệu năng cho mọi hệ thống. Kết quả phụ thuộc vào mô hình GLM-5.3, phần cứng GB200 NVL72, độ dài prompt, tỷ lệ cache hit và hỗn hợp workload do Prime thiết kế. Đây là bằng chứng kỹ thuật hữu ích, nhưng chưa phải so sánh trung lập giữa nhiều nhà cung cấp.
Checklist kiểm thử trước khi đưa AI Agent vào production
- Phát lại workload thật: dùng chuỗi phiên đã ẩn danh, bao gồm prompt dài, tool call và các lượt thất bại; không chỉ chạy prompt mẫu ngắn.
- Đo đủ bốn chỉ số: time-to-first-token, inter-token latency p50/p90, tỷ lệ lỗi gọi công cụ và token/giây/người dùng.
- Tách warm cache và cold cache: benchmark khi lịch sử đã có trong cache và khi phiên bị chuyển sang máy khác.
- Kiểm tra vị trí dữ liệu: xác nhận endpoint đang dùng mô hình hosted hay gateway, khu vực xử lý và thời hạn lưu log.
- Đặt ngưỡng chi phí: giới hạn token theo phiên, theo nhóm và theo tác vụ; cảnh báo khi agent lặp vòng.
Nếu đội ngũ đang thiết kế hạ tầng agent, có thể đọc thêm cách Lenovo đóng gói AI Factory trong 15 ngày, cách Asana dùng Codex xử lý nợ kỹ thuật và góc dữ liệu từ thương vụ Supabase mua Turso để hướng tới một database cho mỗi AI Agent.
Nhận định của Học viện AI
Giá trị lớn nhất của Prime Inference không phải là một con số token khổng lồ, mà là cách nhà cung cấp biến đặc tính của agent dài hạn thành bài toán hệ thống: cache, định tuyến trạng thái, tách prefill/decode và đo độ trễ theo phiên. Doanh nghiệp Việt Nam chưa nhất thiết cần quy mô này, nhưng nên áp dụng cùng cách đo. Một agent “trả lời nhanh trong demo” có thể vẫn chậm, đắt hoặc mất trạng thái khi chạy đồng thời ngoài thực tế.
Muốn thiết kế và kiểm thử AI Agent bằng dữ liệu thật của doanh nghiệp?
Học viện AI hỗ trợ đội ngũ xác định use case, dựng bộ đo và triển khai quy trình AI có kiểm soát.
Nguồn tham khảo
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI