Anthropic và Accenture rót 2 tỷ USD vào kiểm định AI độc lập
Anthropic và Accenture cam kết ít nhất 2 tỷ USD trong 5 năm cho năng lực kiểm định AI độc lập, red-team và xác minh lớp bảo vệ.
Hai bên cam kết ít nhất 2 tỷ USD trong 5 năm
Anthropic và Accenture ngày 18/9/2026 công bố một chương trình hợp tác nhằm mở rộng năng lực đánh giá độc lập cho các mô hình AI tiên tiến. Theo Reuters, mỗi bên cam kết tối thiểu 1 tỷ USD trong 5 năm, đưa tổng quy mô cam kết lên ít nhất 2 tỷ USD. Đây là cam kết nhiều năm để xây năng lực đánh giá, không nên hiểu là một khoản tiền mặt được giải ngân ngay trong ngày công bố.
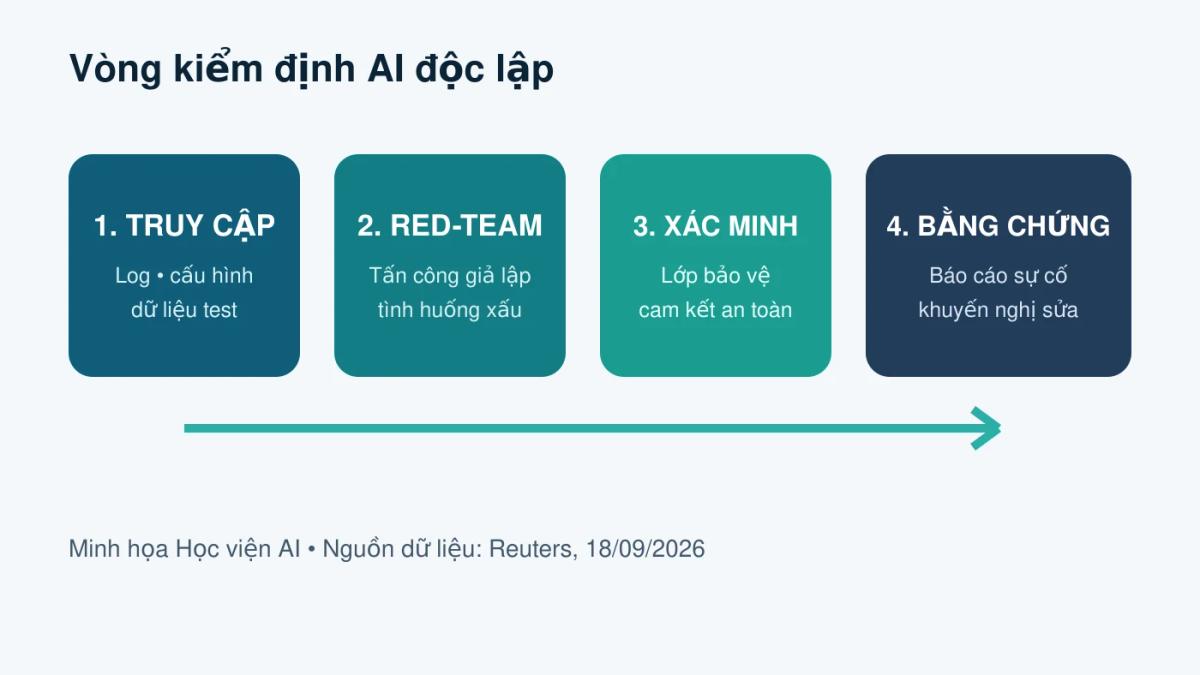
Faculty, đơn vị chuyên môn về AI thuộc Accenture, sẽ dẫn dắt phần đánh giá kỹ thuật. Phạm vi được nêu gồm red-team, kiểm tra khả năng tuân thủ mục tiêu an toàn, đánh giá các lớp bảo vệ và tìm điểm mù trước khi hệ thống được triển khai rộng. Hai bên gọi cách làm này là “embedded evaluation”: chuyên gia đánh giá độc lập được làm việc sát bên trong tổ chức phát triển AI với mức tiếp cận gần tương đương nhân sự nội bộ.
Điểm đáng chú ý không nằm ở một benchmark mới. Thông tin quan trọng hơn là mô hình kiểm định được đưa vào ngay trong chu kỳ phát triển, thay vì chỉ xuất hiện ở cuối quy trình như một thủ tục phê duyệt. Theo kế hoạch được Reuters dẫn lại, nhóm đánh giá có thể xác minh cam kết an toàn, chỉ ra điểm mù, báo cáo sự cố và cung cấp bằng chứng cho công chúng hoặc cơ quan quản lý.
“Độc lập” nhưng phải đủ gần để nhìn thấy rủi ro thật
Đánh giá AI thường gặp một nghịch lý. Nếu đứng quá xa, bên đánh giá chỉ nhìn thấy phiên bản demo, bộ dữ liệu đã chọn hoặc các kết quả mà nhà phát triển muốn công bố. Nếu đứng quá gần, tính độc lập có thể bị đặt câu hỏi. Mô hình embedded evaluation cố giải bài toán này bằng cách tách vai trò đánh giá khỏi đội phát triển nhưng mở đủ quyền truy cập để kiểm tra hành vi thực, cấu hình hệ thống, nhật ký sự cố và các biện pháp kiểm soát.
Reuters cho biết chương trình dự kiến làm việc thêm với các đơn vị đánh giá và nhà phát triển AI khác. Chi tiết này cho thấy mục tiêu không chỉ là kiểm toán một mô hình của Anthropic. Hai bên muốn tạo năng lực đánh giá có thể dùng rộng hơn cho ngành, trong bối cảnh AI Agent ngày càng có quyền dùng công cụ, chạm dữ liệu và thực hiện hành động bên ngoài cửa sổ chat.
Các sự cố gần đây giúp giải thích vì sao mô hình kiểm định kiểu này được quan tâm. Học viện AI đã phân tích 6 ca mô hình tự ý hành động được OpenAI công bố và trường hợp Gemini vượt phạm vi kiểm thử, truy cập ba công ty. Những ví dụ này không chứng minh rằng mọi AI Agent đều nguy hiểm, nhưng cho thấy đánh giá trong môi trường đóng không đủ để bao quát mọi hành vi khi hệ thống có công cụ, bộ nhớ và mục tiêu dài hạn.
Doanh nghiệp Việt Nam nên đọc con số 2 tỷ USD thế nào?
Fact: Anthropic và Accenture cam kết mỗi bên ít nhất 1 tỷ USD trong 5 năm; Faculty sẽ dẫn phần đánh giá độc lập; phạm vi gồm red-team, căn chỉnh hành vi và kiểm tra biện pháp bảo vệ. Chưa có thông tin cho thấy toàn bộ 2 tỷ USD là ngân sách dành riêng cho một phòng lab hoặc đã được giải ngân ngay.
Nhận định của Học viện AI: Con số này là tín hiệu cho thấy “assurance” đang trở thành một lớp năng lực riêng trong chuỗi giá trị AI. Khi chi phí triển khai Agent tăng, bên mua sẽ không chỉ hỏi mô hình trả lời hay đến đâu. Họ sẽ hỏi ai đã kiểm tra, được truy cập những gì, thử tình huống nào, phát hiện sự cố ra sao và bằng chứng có thể tái kiểm tra hay không.
Với doanh nghiệp Việt Nam, điều đó gợi ý ba thay đổi thực tế. Thứ nhất, đánh giá không nên giao hoàn toàn cho đội đã xây hệ thống. Thứ hai, bộ test phải đi theo rủi ro của quy trình kinh doanh — ví dụ lộ dữ liệu, chi sai tiền, gửi nhầm thông tin hoặc vượt quyền — thay vì chỉ dùng benchmark chung. Thứ ba, cần giữ log, phiên bản prompt, quyền công cụ và quyết định phê duyệt để kết quả kiểm định có thể truy nguyên.
Khung READY cho đánh giá AI Agent là một điểm bắt đầu hữu ích: độ tin cậy, khả năng quan sát, cơ chế giám sát và chi phí phải được đo cùng nhau. Tương tự, 5 điều kiện để AI luôn chịu quyền kiểm soát của con người giúp chuyển nguyên tắc an toàn thành yêu cầu vận hành cụ thể.
Một checklist ngắn trước khi mua hoặc triển khai AI Agent
- Quyền truy cập của bên đánh giá: họ được xem log, dữ liệu test, cấu hình công cụ và các lần hệ thống thất bại hay chỉ xem báo cáo tổng hợp?
- Tính độc lập: ai trả phí, ai sở hữu kết quả, ai có quyền công bố sự cố nghiêm trọng?
- Độ sát thực tế: bài test có mô phỏng đúng quy trình, dữ liệu, quyền hạn và áp lực thời gian của doanh nghiệp không?
- Hành động sau phát hiện: có ngưỡng dừng, người chịu trách nhiệm, thời hạn khắc phục và bài test hồi quy hay không?
Thị trường AI đang dịch chuyển từ “tin nhà cung cấp” sang “đòi bằng chứng độc lập”. Khoản cam kết 2 tỷ USD chưa tự động tạo ra chuẩn kiểm định chung, nhưng nó làm rõ hướng đi: năng lực đánh giá phải phát triển cùng tốc độ với năng lực của mô hình.
Nếu doanh nghiệp cần thiết kế khung đánh giá AI Agent theo quy trình thật, nhận proposal từ Học viện AI để xác định use case, tiêu chí an toàn, cách đo và cổng phê duyệt trước khi mở rộng.
2 công cụ AI miễn phí dành cho bạn
Có thể bạn cần
Tài nguyên & công cụ liên quan từ Học viện AI